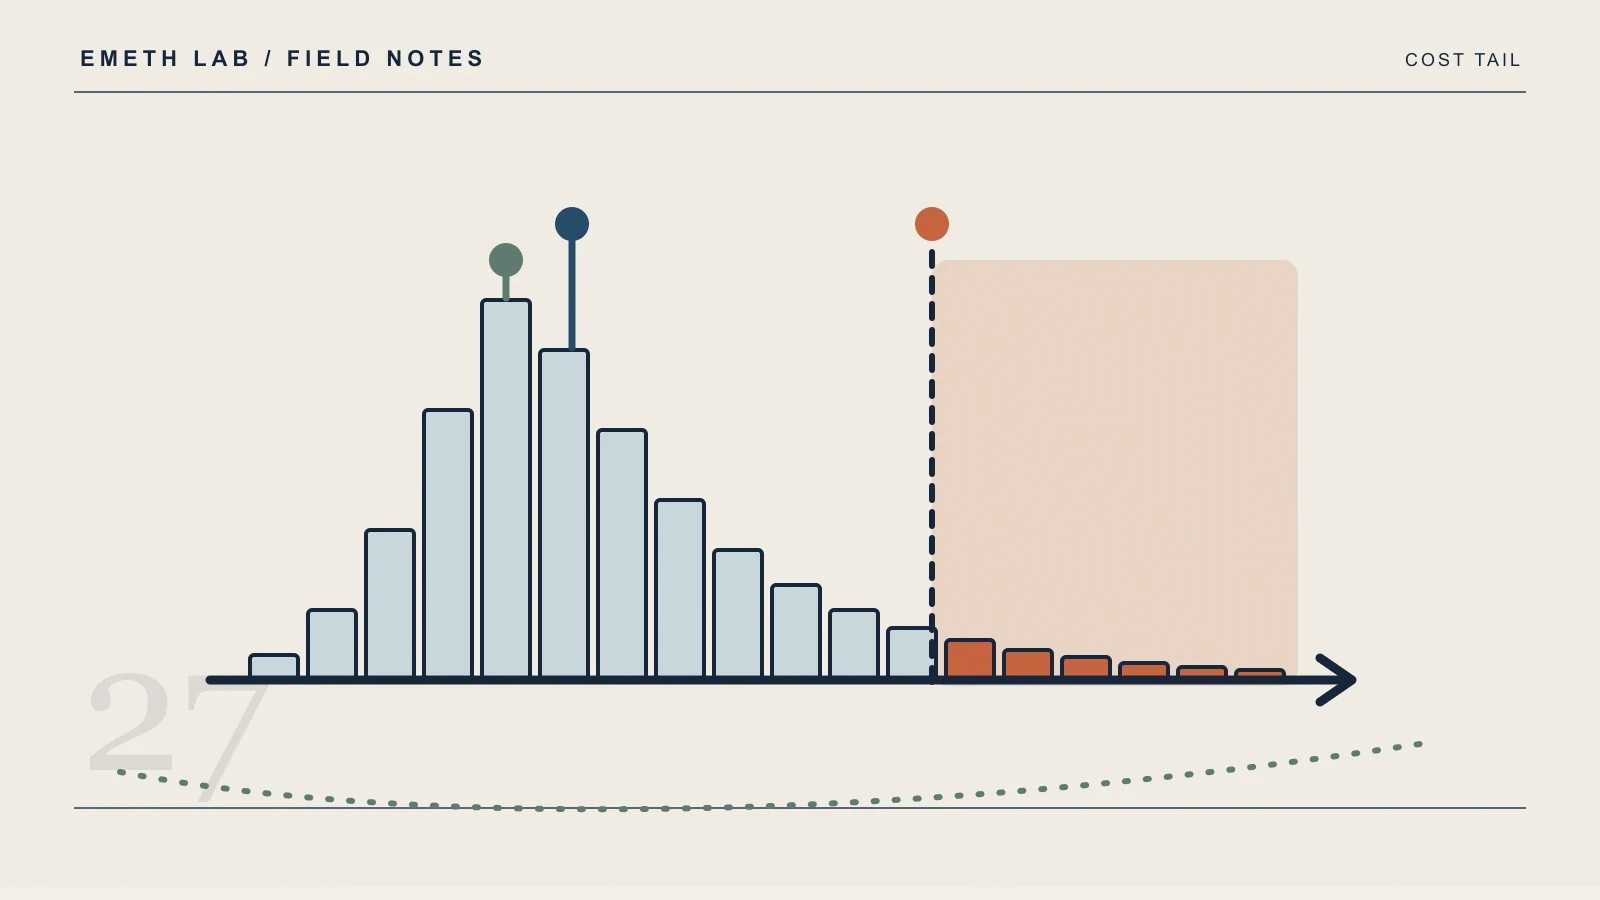
AIエージェントの導入可否を推論APIの単価で議論しても、答えは出ません。単価は下がり続けている一方で、1件の処理にかかる費用は案件ごとに何倍も開くからです。平均値で採算が合うと判断して本番へ移すと、繁忙期と難案件で予算が崩れます。
測るべきは、費用分布の裾と、請求書の外側まで含めた1件あたり総コストです。そこへ人手介入率を重ねると、導入可否はほぼ決まります。自律性の高さは、そのどれでもありません。
費用分布の長い裾
AIエージェントの1件あたり費用は、正規分布になりません。右へ長く伸びます。伸ばしている要因は、おおむね次のどれかです。
- 失敗した処理の再試行。1件の処理が内部で3回動けば、費用も3倍になります
- 長文入力。参照する資料が長い案件ほど入力トークンが増えます
- ツール呼び出しの連鎖。検索、参照、再検索を繰り返す構成では、呼び出し回数が案件ごとに大きく変わります
- 人手介入。担当者が差し戻すと、再実行の費用と確認工数の両方が加算されます
このうち最初の3つは、案件の難易度と相関します。つまり、難しい案件ほど高くつきます。そして難しい案件は、繁忙期に集中しがちです。
だから、平均値と95パーセンタイルを並べて見ます。 95パーセンタイルとは、費用を安い順に並べたとき、全体の95%がその値以下に収まる水準です。上位5%の案件がどこまで高くつくかが、これで分かります。
数字の例を置きます。平均120円、中央値90円、95パーセンタイル380円という分布だとします。平均だけを見ていれば安く見えます。ところが月間1万件なら、総額は約120万円で、うち上位500件が持っていくのは少なくとも19万円です。件数では5%の案件が、費用では15%以上を占めます。380円は上位5%の下限値なので、実際の比率はこれより大きくなります。予算超過は、この500件で起きます。
上限がどこまで伸びうるかの実例として、The New Stackは、OpenAIの研究者によるAIエージェントの実験で1日あたり7,000ドルのコンピューティング費用が発生したと報じています。研究者が上限を試した環境の数字なので、企業の本番運用の費用をそのまま示すものではありません。読み取るべきは金額ではなく、同じ仕組みでも処理の設計次第で費用が桁で変わるという点です。
1件あたり総コストの分解
請求書に載る推論費用は、総コストの一部です。実際に負担しているのは次の合計です。
1件あたり総コスト
= 推論費用
+ ツール・検索費用
+ インフラ費用
+ 人による確認費用
+ エラー・再実行費用
+ 運用管理費用の按分効果から年間総コストを引き、年間総コストで割る。一般的なROIの式そのものは単純です。結果を左右するのは分母の作り方のほうで、ここに推論費用しか入れなければ、どんな案件でも黒字になります。式を書く前に、分母へ何を入れるかを決めます。
測定は、次の3ケースに分けます。まとめて平均すると、また裾が消えます。
- 標準ケース
- 長文・複雑案件
- エラー発生と人手介入が起きたケース
人手介入率の読み方
人手介入率を自律性の指標として使うと、判断を誤ります。この数字は費用の指標です。
「AIが処理の8割を自動で終わらせた」という報告は、残り2割の確認に担当者が1件15分かけているなら、費用の話としては何も言っていません。自動化の比率を上げても、確認工数と再実行費用が残る限り、1件あたり総コストは下がりません。逆に、自動完了率が低いままでも、下書きの品質が上がって確認時間が3分になれば採算は合います。
見るのは、自動で終わった比率ではなく、1件あたりに人が触れた時間の合計です。
効果の証明が難しいことは、開発元自身の動きにも表れています。The New Stackは2026年9月12日、OpenAIがコーディング支援ツールCodexの投資対効果を示す取り組みを強化するため、Git AIの創業者を採用したと報じました。モデルを作っている側でも、効果の測定には専任の人を置いています。自社で導入する場合は、なおさら測定の設計を先に置く必要があります。
ベースラインの取り方
導入後の数字は、導入前の数字がなければ比較できません。AIを入れる前に、最低2〜4週間の実績を記録します。
| 指標 | 記録内容 |
|---|---|
| 処理件数 | 日次と月次の件数 |
| リードタイム | 受付から完了までの時間 |
| 人手工数 | 実作業の時間と確認作業の時間を分けて記録 |
| 品質 | 誤り、差し戻し、再作業の件数 |
| 業務単価 | 人件費、外注費、機会損失 |
| SLA | 期限内に完了した割合 |
「担当者の感覚では半日」は記録になりません。開始時刻と終了時刻を書きます。
あわせて、案件の難易度、担当者、繁忙期かどうかも残します。これがないと、導入後に費用が上がったとき、エージェントの問題なのか案件構成の問題なのかを切り分けられません。
事前に決める判定基準
テストの後に基準を決めると、都合のよい指標だけが選ばれます。開始前に書いて、関係者へ配ります。
| 判定 | 目安 |
|---|---|
| 継続 | 品質基準を満たし、1件あたり総コストが現行以下 |
| 改善 | 効果は出ているが、95パーセンタイル費用または人手介入率が高い |
| 限定利用 | 高リスク業務では使わず、検索と下書きに限定する |
| 中止 | 重大誤り、費用超過、利用が定着しない状態を解消できない |
閾値の例を挙げます。
- 正答率95%以上
- 重大誤りゼロ
- 1件あたりの人の作業時間が現行比30%減
- 95パーセンタイル費用が現行の1件あたり業務単価以下
- SLA遵守率を現行水準以上に維持
重大誤りの定義も先に決めます。軽微な表記ミス、再確認が必要な誤り、そして顧客、設備、契約、法令に影響する誤り。この最後の段だけは平均正答率と別枠で管理します。平均の品質が高くても、重大な誤りを見逃す構成は本番へ移せません。
本番相当のテストは、実データに近い条件で100〜500件を処理します。件数は業務のばらつきと月間処理量に応じて調整します。1件ごとに、推論回数とトークン量、ツール呼び出し回数、人手介入の有無と理由、誤りの種類と重大度、処理時間、1件あたり総コストを記録します。
測る単位としての業務
全社共通のAI導入ROI指標を1本作る設計は、機能しません。The New Stackは、AIネイティブなソフトウェア開発ライフサイクルは単一のプロセスにはならないと論じています。工程ごとに、どこへ確認の関門を置くかが変わるためです。同じことが業務にも当てはまります。工程が違えば、費用の裾の伸び方も、人が確認すべき点も変わります。
そこで、対象を一つに絞って測ります。選定の条件は次のとおりです。
- 入力データがある程度標準化されている
- 現行の処理時間を測定できる
- 最終判断者が明確である
- 誤りが出たときの影響範囲を限定できる
- 月間処理件数が一定以上ある
製造業なら、保全記録や作業報告書の検索と要約が候補になります。過去の記録100〜500件を対象に、検索時間、回答の正確性、確認工数を比較します。設備の停止や操作指示をエージェントに任せる場合は、権限管理と人による承認を別に設けます。
エネルギーや水処理の事業なら、異常報告書の分類と過去事例の検索です。最初は報告書の下書きに限り、設備操作と顧客への確定回答は担当者の承認後に実行します。
従業員100〜500人規模の企業の管理部門なら、社内規程や申請手続きに関する問い合わせの回答案作成です。まず過去の問い合わせを分類し、回答時間と差し戻し率をベースラインとして記録します。
いずれも、完全自動化から始める必要はありません。検索、要約、分類、下書きのように誤りの影響を限定しやすい業務から入り、数字を見ながら範囲を広げます。
つまずきやすい点
推論費用だけでROIを計算する。 単価が安くても、確認者の工数と障害対応が増えれば全体では割高になります。人手介入率と確認時間を必ず費用へ換算します。
処理時間の短縮をそのまま利益とみなす。 担当者の空き時間が別の業務に使われなければ、会計上の利益は出ません。削減した時間の使途を、受注増、保全の高度化、残業削減などに分けて記録します。
通常案件だけで評価する。 標準ケースと高負荷ケースを分け、平均値、中央値、95パーセンタイル、必要なら最大値を確認します。
経営と現場で成功指標が違う。 経営層は投資回収期間と総コストを、現場は使いやすさと確認負担を見ます。両方を同じ画面に並べ、月次で差分を議論します。
実行チェックリスト
- 対象業務を一つに絞った
- 現行業務の処理件数、時間、品質を2〜4週間記録した
- 推論費用以外の費用項目を洗い出した
- 1件あたり総コストの計算式を決めた
- 標準ケースと高負荷ケースを分けた
- 平均値と95パーセンタイルの両方を出す設計にした
- 人が1件に触れた時間を記録できるようにした
- 重大誤りの定義を決めた
- 本番相当の100〜500件テストを計画した
- 継続、改善、限定利用、中止の基準を開始前に決めた
- 高リスク操作に人の承認を設定した
未確認事項
本文に出した平均120円、中央値90円、95パーセンタイル380円という分布は、裾の効き方を説明するために置いた数値であり、特定の案件の実測値ではありません。実際の分布は、モデル、処理設計、案件構成によって変わります。
1日7,000ドルという金額は、研究者が実験環境で使った額として報じられたものです。企業の本番運用の費用水準を示すものではありません。
判定基準として挙げた閾値も同様に一例です。顧客対応、設備操作、法令判断のように誤りの影響が大きい業務では、コスト削減より安全性と承認プロセスを優先する設定になります。