自己修復運用とは
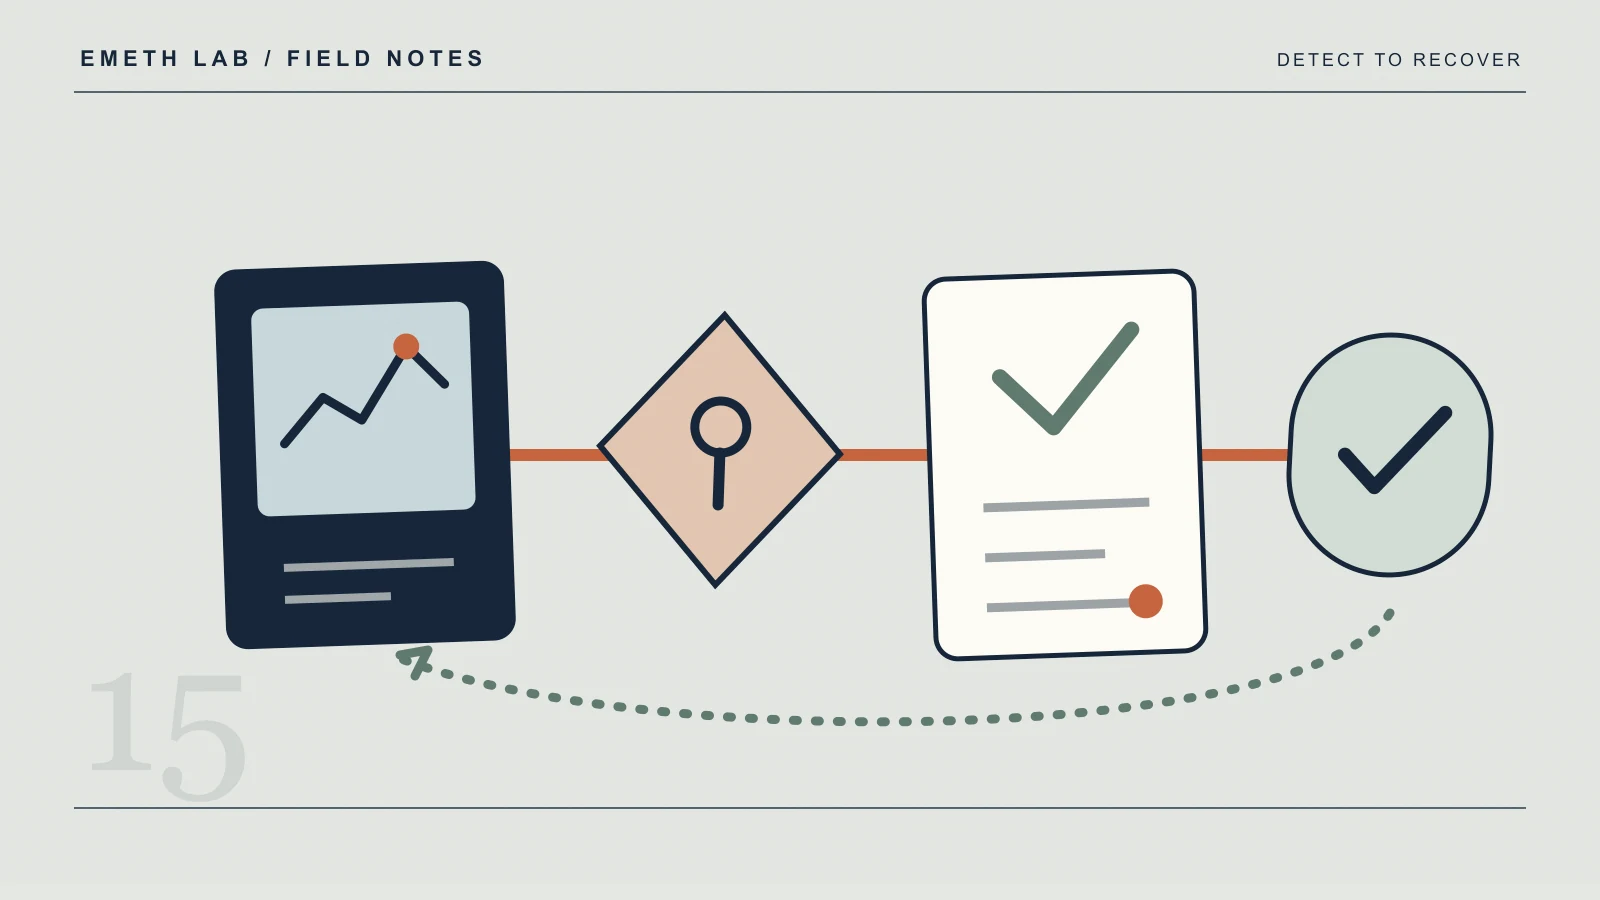
自己修復運用とは、設備やITシステムの異常を検知し、あらかじめ定めた条件に基づいて再起動、切り替え、隔離などを実行し、正常性まで確認する運用方式です。「異常を見つける監視」で終わらず、「安全に戻せたか」を確認するところまでを一つのループにします。
すべての障害を自動で直す仕組みではありません。影響範囲や安全性を判断できない場合は止まり、人へ引き継ぐことも自己修復運用の重要な機能です。
GPUノードの事例から分かること
Amazon EKSには、ノード監視エージェントがカーネル、コンテナ実行環境、ネットワーク、ストレージ、GPUなどの状態を検知し、自動ノード修復と連携する仕組みがあります。異常の種類に応じて、ノードの再起動や置き換えにつなげます。
EKS Node Monitoring Agentの開発事例では、次のような実務上の論点が示されています。
- 検知と診断は目的と負荷が異なるため分ける
- 監視していない状態を「正常」と扱わない
- 判定コードや重大度の変更を互換性の問題として扱う
- 監視自体が本番処理へ与える負荷を抑える
- 一斉復旧を防ぐ安全弁を設ける
この考え方は、GPU基盤に限らず、工場の周辺システムやエネルギー設備の監視にも応用できます。
自己修復を成立させる4段階
| 段階 | 役割 | 代表例 | 設計時の問い |
|---|---|---|---|
| 検知 | 状態変化を捉える | メトリクス、イベント、ログ | 何を異常の根拠にするか |
| 判定 | 復旧してよいか決める | 重大度、継続時間、影響範囲 | 一時的な揺れと故障を区別できるか |
| 復旧 | 安全な処置を実行する | 再起動、切り替え、隔離、縮退 | どこまで自動実行してよいか |
| 検証 | 正常性と副作用を確認する | ヘルスチェック、品質確認 | 戻らない場合に停止・通報できるか |
復旧処理だけを自動化しても、検証がなければ誤復旧を見逃します。検知から検証まで同じ障害IDで記録し、どの条件で何を実行したか追えるようにします。
自動復旧してよい範囲の決め方
製造現場では、対象を安全性と品質への影響で分けます。
自動復旧を検討しやすい領域
- 監視サーバー、分析基盤、エッジノード
- 冗長化された通信・アプリケーション基盤
- 手順が固定されたサービス再起動
- 失敗しても安全側へ戻せる処理
条件付きで自動化する領域
- 画像検査、予兆保全、MES連携など品質へ影響する周辺系
- データ欠損時の代替処理が必要なシステム
- 復旧後に再検査や整合性確認が必要な処理
人の判断または安全停止を優先する領域
- PLCや重要プロセス制御
- 人身安全へ影響する設備
- 復旧後の状態を自動判定できない処理
- 原因不明の連続障害や複数設備の同時異常
予兆保全と復旧の役割分担は予兆保全を運用へ定着させる設計でも解説しています。
停電・通信断では「修復」より縮退を先に設計する
Waymoは2026年7月、停電の影響を受けてサンフランシスコのサービスを約1時間停止し、その後再開したと報じられました。これは自己修復の導入事例ではありませんが、外部電源や交通信号のように自社で修復できない依存先がサービス継続を左右する例です。
外部要因まで自動で直すことはできません。その場合は、次の順序で運用を設計します。
- 電源断や通信断を検知する
- 影響範囲と利用できる代替経路を確認する
- 限定機能や安全側停止へ移る
- 復旧条件がそろうまで再開を保留する
- 復旧後にデータ整合性と安全性を確認する
エネルギーとIT基盤の依存関係はAIインフラの電力・設備計画も参考になります。
導入する7つの手順
- 障害履歴から繰り返し発生する一件を選ぶ
- 検知に使う信号と正常状態を定義する
- 自動復旧してよい条件と禁止条件を書く
- 実行する処置とタイムアウトを決める
- 復旧後のヘルスチェックと品質確認を決める
- 連続失敗、一斉障害、原因不明時の安全弁を設ける
- 通知付きで試験し、誤復旧がないことを確認して範囲を広げる
最初の対象は、影響範囲が限定され、手動復旧の手順が安定し、正常性を機械判定できるものが適しています。工場全体ではなく、画像検査サーバー一台の再起動や、冗長系への切り替えなどから始めます。
見るべきKPI
| KPI | 確認すること |
|---|---|
| 平均検知時間(MTTD) | 異常発生から検知までの時間 |
| 平均復旧時間(MTTR) | 異常発生から正常確認までの時間 |
| 自動復旧成功率 | 自動処置後に正常性確認まで通った割合 |
| 誤復旧率 | 不要または不適切な復旧を実行した割合 |
| 人手介入率 | 自動ループから人へ引き継いだ割合 |
| 再発率 | 復旧後に同じ障害が再発した割合 |
| 安全弁の作動件数 | 一斉復旧や連続試行を止めた件数 |
最初から自動化率を最大化する必要はありません。MTTRを短くしながら、誤復旧率と再発率を悪化させないことを優先します。ログ・メトリクス・トレースの整理はAIエージェント運用監視の設計にも共通します。
実行チェックリスト
- 対象障害と正常状態を具体的に定義したか
- 復旧してよい条件と禁止条件を分けたか
- 一時的な揺れを待つ猶予時間があるか
- 復旧処理に回数制限とタイムアウトがあるか
- 復旧後の正常性と品質を自動確認できるか
- 複数設備の同時異常時に一斉復旧を止められるか
- 原因不明時に人へ引き継げるか
- 検知、判断、処置、結果を同じ障害IDで追えるか
まとめ
自己修復運用は、異常検知と自動再起動を組み合わせただけの仕組みではありません。検知・判定・復旧・検証の4段階を設計し、直してよい条件と止まる条件を明確にする運用です。まず、繰り返し発生している低リスクな障害を一件選び、手動復旧の手順と正常性確認をそのまま自動ループへ落とし込んでください。