はじめに
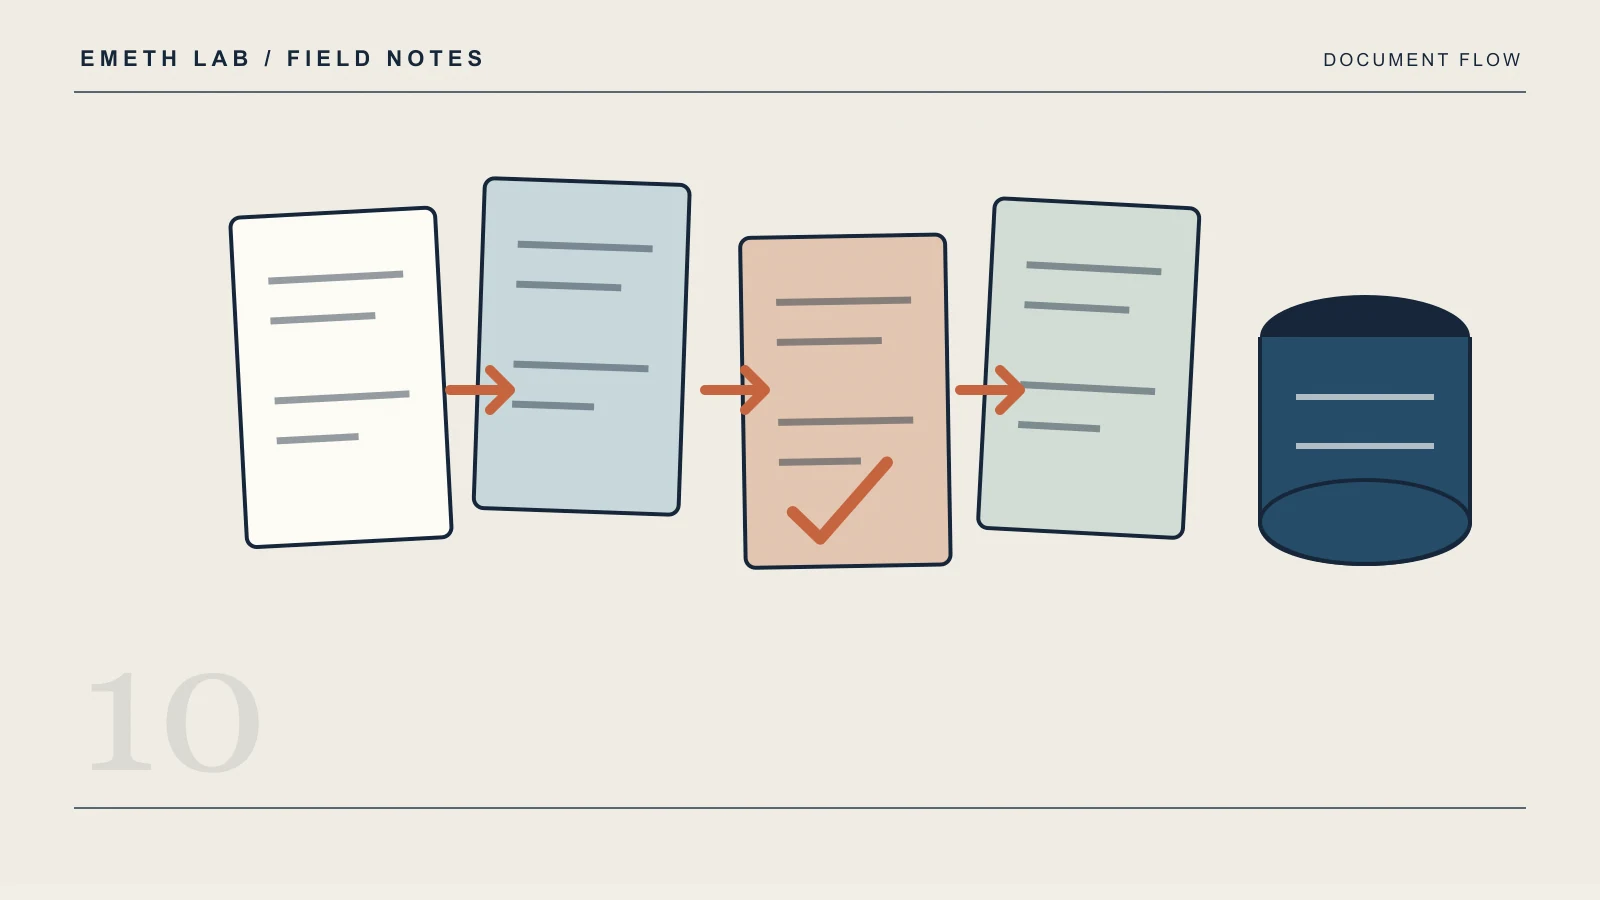
AI-OCRの価値は、紙やPDFを文字へ変えることではなく、必要項目を検証可能なデータにし、既存業務へ安全に渡すことにあります。受付、分類、抽出、検証、人の修正、登録までを一つの処理として設計し、原本と修正履歴を残すことで、文書処理は継続的に改善できます。
Google CloudのDocument AIも、文書処理をOCRだけでなく、分類、分割、項目抽出、構造化、保存・検索との連携まで含む流れとして説明しています。手書き文字を含む文書も対象にできますが、読取可能だから自動登録してよいとは限りません。
文字読取だけでは業務が終わらない
請求書を例にすると、全文テキストが得られても、取引先、請求番号、金額、税、支払期限を正しく区別し、重複を検知し、会計システムの形式へ合わせる必要があります。点検票なら、設備ID、点検項目、値、単位、異常コメントを分け、設備マスタと照合します。
読取率だけをKPIにすると、後工程の修正負荷や誤登録を見落とします。業務で使う項目ごとの正しさと、人が直した内容を測る必要があります。
文書処理をつなぐ六段階
1. 受付
メール、アップロード、スキャンなど入口を限定し、受信時刻、送信元、ファイル、案件IDを記録します。同じ文書の再送を検知できるよう、ファイル指紋や文書番号も利用します。
2. 分類と分割
請求書、注文書、点検票など文書種類を判定します。複数文書を一つのPDFで受け取る場合は、ページ単位で分割してから処理します。分類できない文書は人へ戻します。
3. OCRと項目抽出
全文テキスト、表、チェックボックス、手書き、主要項目を抽出します。画像品質、ページ回転、欠け、解像度も同時に確認します。Enterprise Document OCRは、読取品質のスコアと品質低下の理由を返す機能を提供しています。
4. 業務ルールで検証
必須項目、日付形式、金額整合、マスタ存在、重複、許容範囲をコードで確認します。AIの確信度だけで登録可否を決めず、業務ルールと組み合わせます。
5. 人が修正する
不明箇所だけを原本画像と並べて確認できる画面を用意します。誰が何を直したかを記録し、同じ誤りが繰り返されるか分析します。個人情報や機密文書は、閲覧範囲と保存期間を用途に合わせて制限します。
6. 業務システムへ登録する
検証済みデータだけをAPIやRPAへ渡します。登録結果とシステム側のIDを元の案件IDへ戻し、処理の完了を確認します。曖昧な抽出と確定登録を分ける考え方は、AIエージェントとRPAの使い分けにも共通します。
最初の対象文書の選び方
件数が多く、形式が比較的安定し、修正結果を取得できる文書が向いています。帳票種類が多すぎる、原本品質が極端に悪い、誤登録の影響が大きい文書は、最初から完全自動化しません。
最初の評価では、ページ単位の読取率より、必須項目の正解率、要確認率、一件あたり修正時間、登録エラー、重複検知を見ます。処理対象の個人情報をどこへ送るかは、ローカルAIとクラウドAIの安全性で整理したデータフローの観点から確認してください。
実行チェックリスト
- 文書種類と入口を限定した
- 原本と処理結果を案件IDで結んだ
- 必須項目を項目単位で評価する
- 画像品質の低い文書を人へ戻す
- マスタ照合と重複検知を行う
- 修正者と修正内容を記録する
- 個人情報の保存先と保持期間を決めた
- 登録結果を元文書へ戻している
まとめ
AI-OCR導入では、文字認識をゴールにせず、分類、項目抽出、業務検証、人の修正、登録までを一つの処理として設計します。一種類の文書から始め、原本と修正履歴を残すことで、誤登録を防ぎながら自動化範囲を広げられます。