はじめに
生成AIの議論は、モデルの性能比較だけでは終わらなくなりました。いま現場で問われているのは、「どのモデルを使うか」よりも、「どの基盤の上で、どこまで自社で持つか」です。特に製造業、エネルギー、化学、水処理のように、機密データや現場制約が強い業界では、クラウド前提の一択では運用が回らない場面が増えています。AI基盤とモデル選定は、実験ではなく業務設計の問題になっています。
最新動向
NVIDIAとNoetraは、日本に「Vera Rubin AI factory」を設立する計画を発表しました。AIの開発・運用を支える拠点として、計算基盤や関連技術の整備を進め、日本でのAI活用を後押しする狙いです(engineering.com, 2026年7月)。
一方で、オープンウェイトの大規模モデルも存在感を増しています。Kimi K3はArenaのコーディング・リーダーボードで首位となり、利用や検証のハードルが下がるオープンウェイト提供が注目されています(The New Stack, 2026年7月)。また、Kimi K3 2.8T-A50Bは、これまでで最大級のオープンモデルとして報じられました(Latent Space, 2026年7月)。
さらに、軽量化の流れも進んでいます。270億パラメーターのLLM「Bonsai 27B」は、スマホでも動かせることをうたい、モバイル環境での生成AI活用の可能性を示しました(ITmedia AI+, 2026年7月)。Googleは「NotebookLM」を「Gemini Notebook」に改称し、Geminiエコシステムへの統合を強化しています(ITmedia News, 2026年7月)。
AI基盤はモデル名より5つの判断軸で選ぶ
新しいモデルが出るたびに基盤を入れ替える設計では、業務運用が安定しません。先に次の5軸でユースケースを評価し、その後でモデルと実行環境を選びます。
| 判断軸 | 確認すること | 基盤選択への影響 |
|---|---|---|
| 機密性 | 個人情報、製造条件、契約情報を含むか | 高いほど閉域・オンプレ寄り |
| 応答速度 | ミリ秒・秒単位の応答が必要か | 厳しいほどエッジ寄り |
| 外部連携 | SaaSや公開情報へ接続するか | 多いほどクラウドが扱いやすい |
| 運用責任 | 障害対応や更新を自社で担えるか | 担えない場合は管理サービス寄り |
| 総コスト | 開発費だけでなく3年間の運用費はいくらか | 利用量と固定費を比較する |
同じ企業でも、ユースケースごとに答えは変わります。機密性の高い設備データを工場内で処理し、匿名化した結果だけをクラウドで集計するような分割が現実的です。
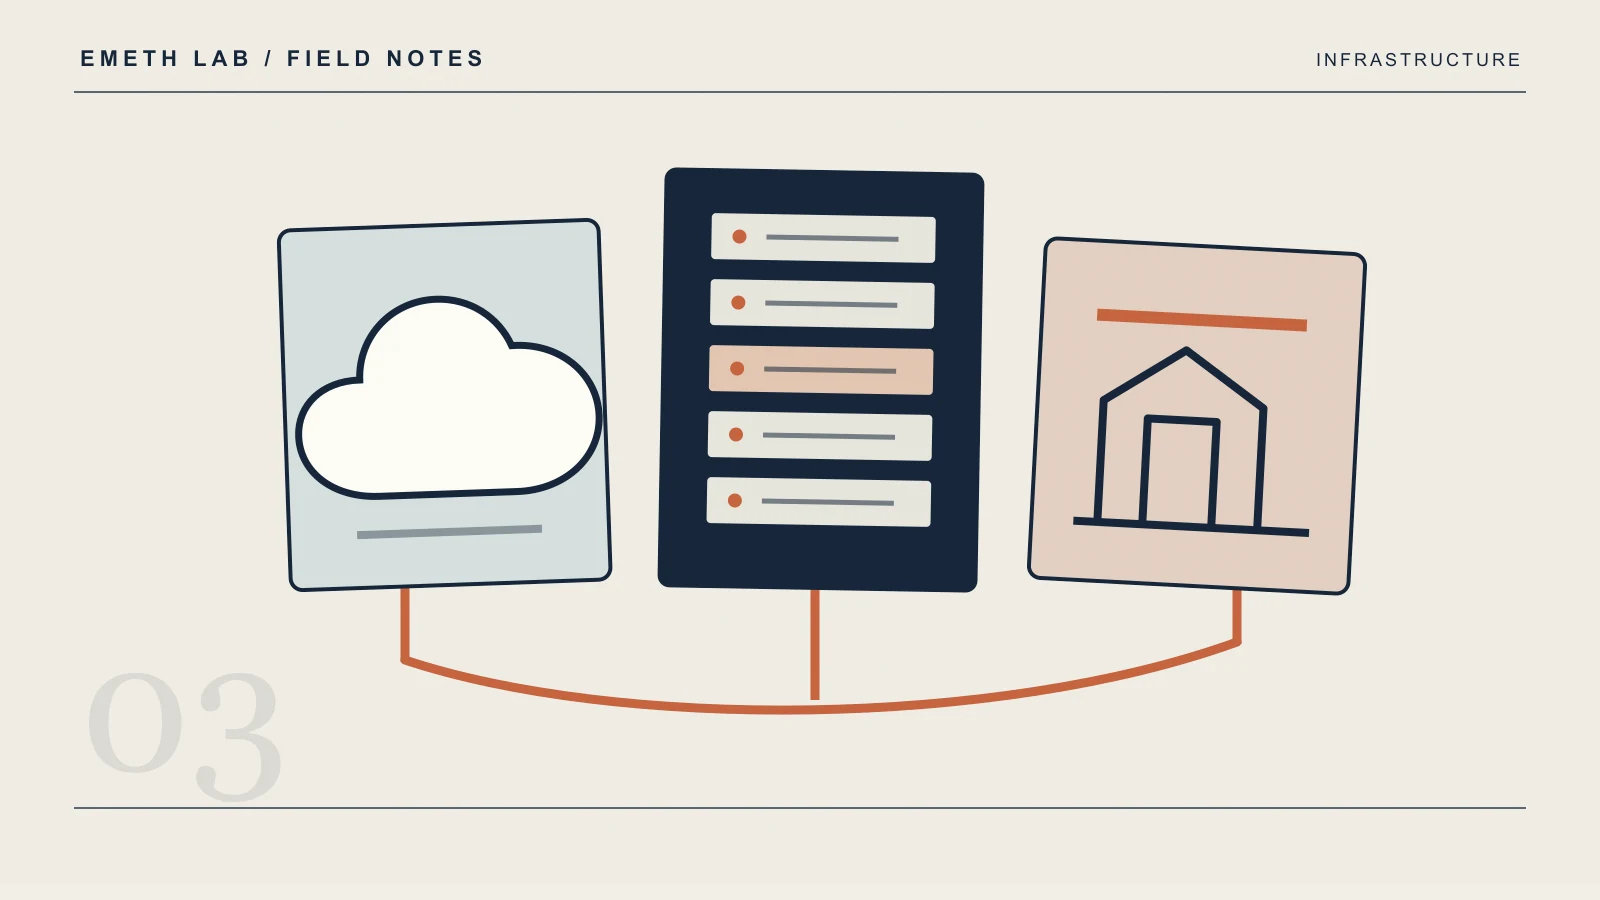
クラウド・オンプレミス・エッジの使い分け
クラウドが向く業務
技術文書の下書き、社内ナレッジ検索、営業支援など、外部サービスとの連携が多く、利用量が変動する業務に向きます。導入速度は高い一方、データ送信範囲、リージョン、保存条件、ベンダー変更時の移行性を確認します。
オンプレミスが向く業務
設計図、配合、製造条件など、外部へ出せない情報を継続的に扱う業務に向きます。自由度と統制は高いものの、GPU調達、モデル更新、監視、障害対応まで自社の責任になります。
エッジが向く業務
外観検査、設備異常、作業支援など、通信遅延や回線断の影響を受けられない業務に向きます。小型モデルの精度だけでなく、端末更新、現場での交換、複数拠点への配布まで設計対象です。
見落としやすい総コスト
AI基盤の比較では、API単価やGPU価格だけでなく、次の費用を含めます。
- データ整備、権限設定、評価データ作成の初期費用
- 監視、障害対応、セキュリティ更新の運用費用
- モデル変更やベンダー移行に備えた接続層の保守費用
- 出力確認、例外処理、再学習にかかる人件費
- 監査やインシデント対応に必要な証跡保管費用
エージェントが外部システムを操作する場合は、基盤選びと同時に判断と操作を追跡する証跡設計も必要です。
90日で作るAI基盤ロードマップ
0〜30日:業務を分類する。 候補業務を5つの判断軸で採点し、クラウド、オンプレミス、エッジの仮配置を作ります。この段階ではモデル名を固定しません。
31〜60日:2つの構成を比較する。 同じ評価データを使い、品質、応答時間、運用工数、月額費用を測ります。性能だけでなく、障害時に人へ戻せるかも確認します。
61〜90日:責任分界を決める。 データ管理者、モデル更新担当、業務承認者、障害対応者を明確にし、1つの業務で本番運用を始めます。基盤の全社標準化は、この運用結果を見てから判断します。
日本企業への示唆
示唆は明確です。AI基盤は「大規模クラウド一択」でも「完全内製一択」でもなく、業務ごとに置き場所を分ける発想が必要です。たとえば製造業では、設備保全や品質異常の一次判定は工場内や閉域環境、文書要約やナレッジ検索はクラウド、という分け方が現実的です。
大企業であれば、最初の一歩は「業務を3分類すること」です。機密性が高い、応答速度が重要、外部連携が多い、の3軸でユースケースを棚卸しし、どの業務をオープンウェイトモデルで検証し、どの業務を商用APIに任せるかを決めます。ここで重要なのは、モデル名ではなく、GPU・ネットワーク・権限管理まで含めた基盤要件を先に固めることです。
中小企業では、いきなり大規模なAI基盤を作るより、まずは1部門で「軽量モデル+既存端末」で試すのが現実的です。たとえば営業支援や技術文書の下書き生成など、失敗コストが低い業務から始め、1〜2週間で利用ログと工数削減を確認します。Bonsai 27Bのような軽量化の流れは、こうした小さな実証に向いています。
スタートアップは、差別化の核がデータか速度かで選択が変わります。独自データが競争力ならオープンウェイトを前提に自社チューニングを検討し、提供速度が最優先なら商用API中心で市場投入を急ぐ方がよいです。最初の一歩は、1つの主要機能について「自前で持つ部分」と「外部に委ねる部分」を1枚に描くことです。
基盤と業務を切り離さずに進めるには、AIエージェント導入前に整理すべき3つの論点も併せて確認してください。
データ配置を決める際はローカルAIの安全性チェック、設備投資と運用費を比べる際はAI基盤の電力コストの見積もり方まで一続きで評価します。
まとめ
AI基盤の選定は、モデル性能の優劣だけで決める時代ではありません。私の実務感覚では、成果が出る企業ほど「どの業務を、どの基盤で、どこまで運用責任を持つか」を先に決めています。日本企業に必要なのは、最新モデルを追うこと以上に、現場で回る構成を冷静に設計することです。