はじめに
生成AIやAIエージェントを社内で使いたいが、機密情報を外に出せない企業向けに、推論基盤の設計観点と導入の進め方を整理します。
生成AIの活用は、もはや「使うかどうか」ではなく「どこまで安全に使えるか」の問題です。特に製造、エネルギー、化学、水処理のように、設計図、配合、運転条件、保守記録などの機密を扱う現場では、推論時の情報漏えいと誤動作の両方を防ぐ基盤設計が必要です。この記事では、セキュア推論基盤をどう考え、何から導入すべきかを実務目線で示します。
最新動向
RANDは2026年8月、セキュア推論データセンターという論点を提示しました。AI推論を安全に実行するために、ハードウェアから運用までを縦に貫いてセキュリティを設計するという考え方で、モデルではなく推論環境そのものを統制の対象として扱う発想です(RAND, 2026年)。
加えて、AIエージェントの配備後ガバナンスでは、計算資源の配分を通じて行動を制御する考え方が提案されています。これは、推論基盤側で「どのエージェントに、どれだけ、何を許すか」を制御する設計が必要だという示唆につながります(arXiv:2608.06353, 2026年)。
さらに、外部文脈を過信すると誤誘導に弱くなる可能性が示されており、モデルは与えられた文脈を常に正しいものとして扱うとは限らないと考えるべきです(arXiv:2608.06377, 2026年)。
セキュア推論基盤とは何か
セキュア推論基盤とは、生成AIやAIエージェントが推論する際に、機密データを守りながら、必要な情報だけを安全に渡し、出力も統制する仕組みです。学習基盤ではなく、実運用の推論を守る点が重要です。
事実
- 推論時には、入力プロンプト、検索結果、会話履歴、ツール実行結果が混在します。
- AIエージェントは、単発応答ではなく、検索・要約・実行を連続して行うため、権限管理が複雑になります。
- 外部文脈は誤誘導を含み得るため、検索結果をそのまま信用すると誤答や情報漏えいにつながるおそれがあります(arXiv:2608.06377, 2026年)。
筆者の見解
セキュア推論基盤の本質は、モデル性能ではなく「データの流れ」と「権限の流れ」を分離して制御することです。
つまり、モデルを賢くする前に、誰のデータをどこへ渡し、何を参照し、何を返してよいかを決める必要があります。
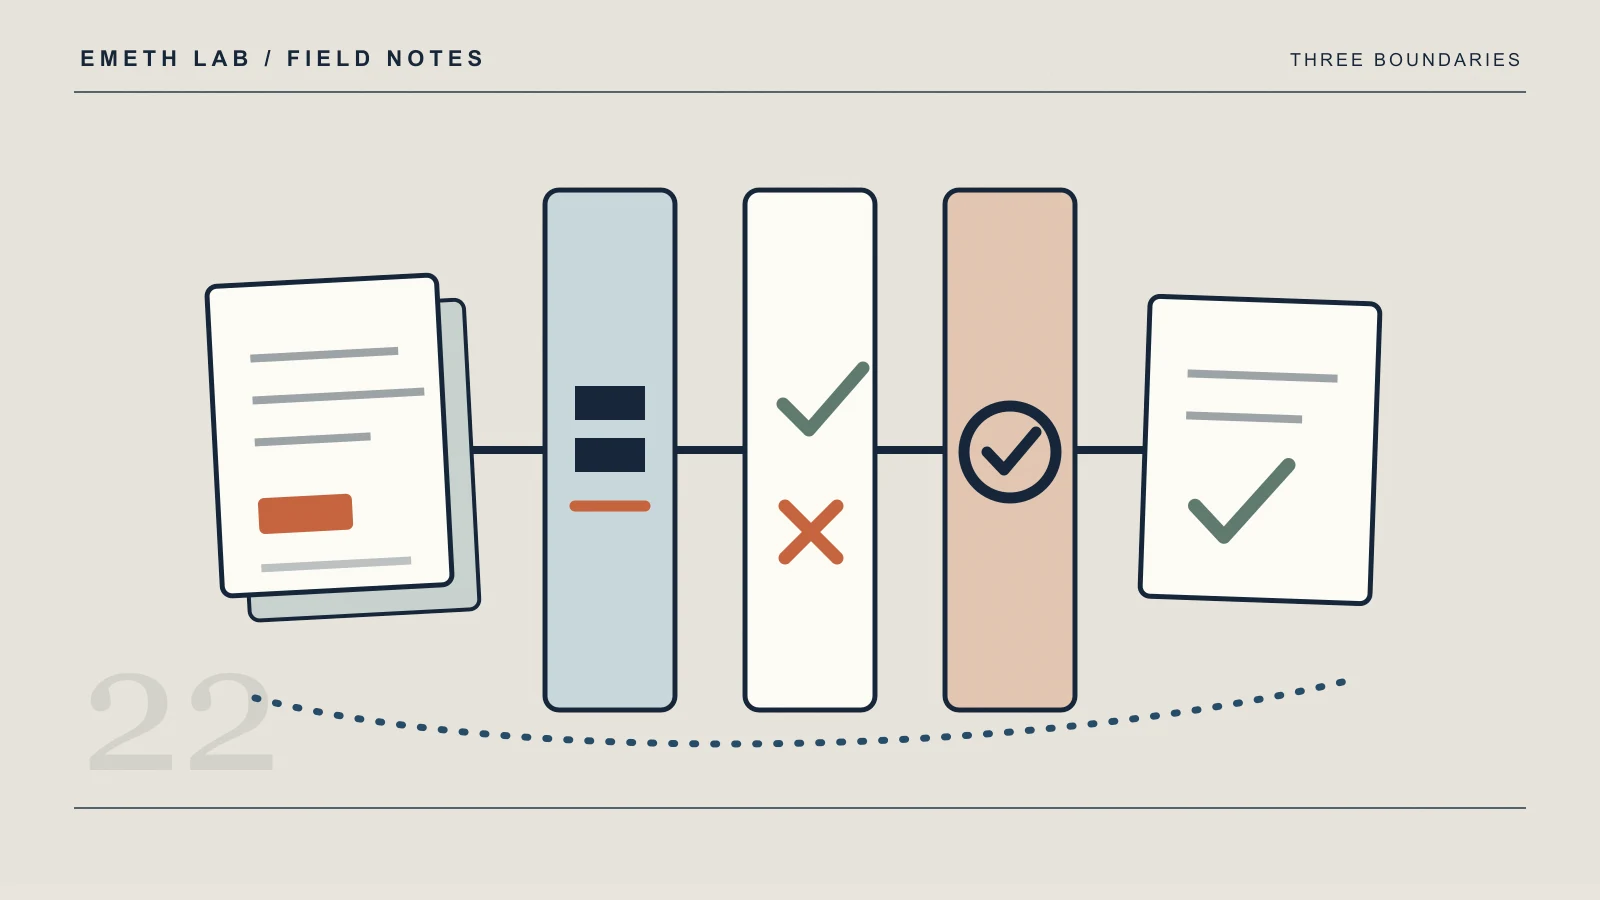
設計の中心は三つの境界です
1. データ境界
機密情報をそのままモデルに渡さない設計です。
具体的には、入力前のマスキング、機密区分ごとのルーティング、検索対象の限定が必要です。
2. 実行境界
AIエージェントが使えるツールやAPIを制限する境界です。
たとえば、保全提案はできても、発注確定や設定変更はできないように分けます。
3. 出力境界
生成結果の公開範囲を制御する境界です。
要約、翻訳、提案、実行指示を同列に扱わず、承認が必要な出力を分離します。
推論基盤の比較軸
| 観点 | 一般的な生成AI利用 | セキュア推論基盤 |
|---|---|---|
| データ取り扱い | ユーザー任せ | 区分・マスキング・監査を標準化 |
| 権限管理 | 画一的 | ユーザー、文書、ツール単位で制御 |
| 外部接続 | 利便性優先 | 許可先を限定し記録を残す |
| 出力制御 | 自由度が高い | 機密・危険操作を抑止 |
| 運用監視 | 断片的 | ログ、異常検知、再学習を連動 |
判断軸
導入可否は「使えるか」ではなく、次の4点で判断すると実務的です。
- 機密データを入力してもよいか
- 外部検索やツール実行を許してよいか
- 誰が最終責任を持つか
- 監査証跡を残せるか
この4点に答えられないなら、まだ本番運用の段階ではありません。
導入手順は段階化が重要です
1. 対象業務を1つに絞る
最初から全社展開せず、問い合わせ対応、技術文書検索、保全ナレッジ整理など、読み取り中心の業務から始めます。
たとえば製造業なら「設備保全の問い合わせ対応」、金融なら「社内規程の検索支援」、自治体なら「文書要約支援」のように、まずは1業務だけに限定します。
2. データ区分を決める
公開、社内限定、秘匿、極秘のように区分し、どの区分を推論に使えるかを明文化します。
あわせて、「入力してよい情報」「入力禁止情報」「要承認情報」を一覧化すると運用しやすくなります。
3. ツール権限を分ける
検索、要約、チケット起票、設備制御などを同じ権限でつなげない設計にします。
たとえば、保全提案は可能でも、発注確定や制御パラメータ変更は人の承認を必須にします。
4. 監査ログを先に作る
誰が、何を入力し、どの文書を参照し、何を出力したかを追えるようにします。
これは後付けではなく、最初から必要です。
最低でも、ユーザーID、時刻、参照文書ID、実行ツール、出力内容、承認者を記録しておくと、事故時の追跡がしやすくなります。
5. 人の承認点を置く
危険度の高い出力は、AIが提案し、人が承認する流れにします。
AIエージェントを自律化するほど、承認点の設計が重要になります(arXiv:2608.06353, 2026年)。
6. 小さく試し、拡張条件を決める
PoCの段階で「何ができれば次に進むか」を決めます。
たとえば、誤答率、機密情報の混入件数、承認漏れ件数、ログ欠損率などを基準にして、本番移行の判断を明確にします。
失敗パターン
- 社内文書を全部つなぎ、検索精度だけで安全性を判断する
- 権限管理をID管理だけで済ませる
- 出力の危険度を区別せず、全て同じ画面に出す
- ログを残さず、事故時に追跡できない
- PoCで便利さを示した後、本番の統制設計がないまま拡大する
日本企業への示唆
製造業では、設備保全や品質異常の要約から始めるのが現実的です。大企業なら、まず1工場・1部門で文書検索と要約に限定した推論環境を切り出し、秘匿図面や制御系には接続しない構成を作るのが第一歩です。中小企業なら、クラウド利用時のデータ区分と入力禁止情報を1枚にまとめるところから始めるとよいです。
金融なら、顧客情報を含む問い合わせ支援で、検索対象と出力文面の制限を先に決めることが出発点になります。
自治体やインフラ事業者では、住民情報や設備情報を扱う前に、まずは庁内文書や保全マニュアルの検索支援に限定し、外部接続を閉じた環境で検証するのが安全です。
実行チェックリスト
- 推論に使うデータ区分を定義している
- 入力禁止情報を明文化している
- 検索対象の文書範囲を限定している
- ツール実行権限を業務ごとに分けている
- 出力の承認が必要なケースを定義している
- 監査ログで入力、参照、出力を追跡できる
- 事故時の停止手順が決まっている
- PoCから本番への移行条件がある
まとめ
セキュア推論基盤は、生成AIを「使うための箱」ではなく、機密を守りながら業務に組み込むための統制基盤です。重要なのは、モデル選定より先に、データ境界、実行境界、出力境界を設計することです。まずは一業務に絞り、権限とログを含む最小構成を作ることが、導入成功への最短ルートです。