はじめに
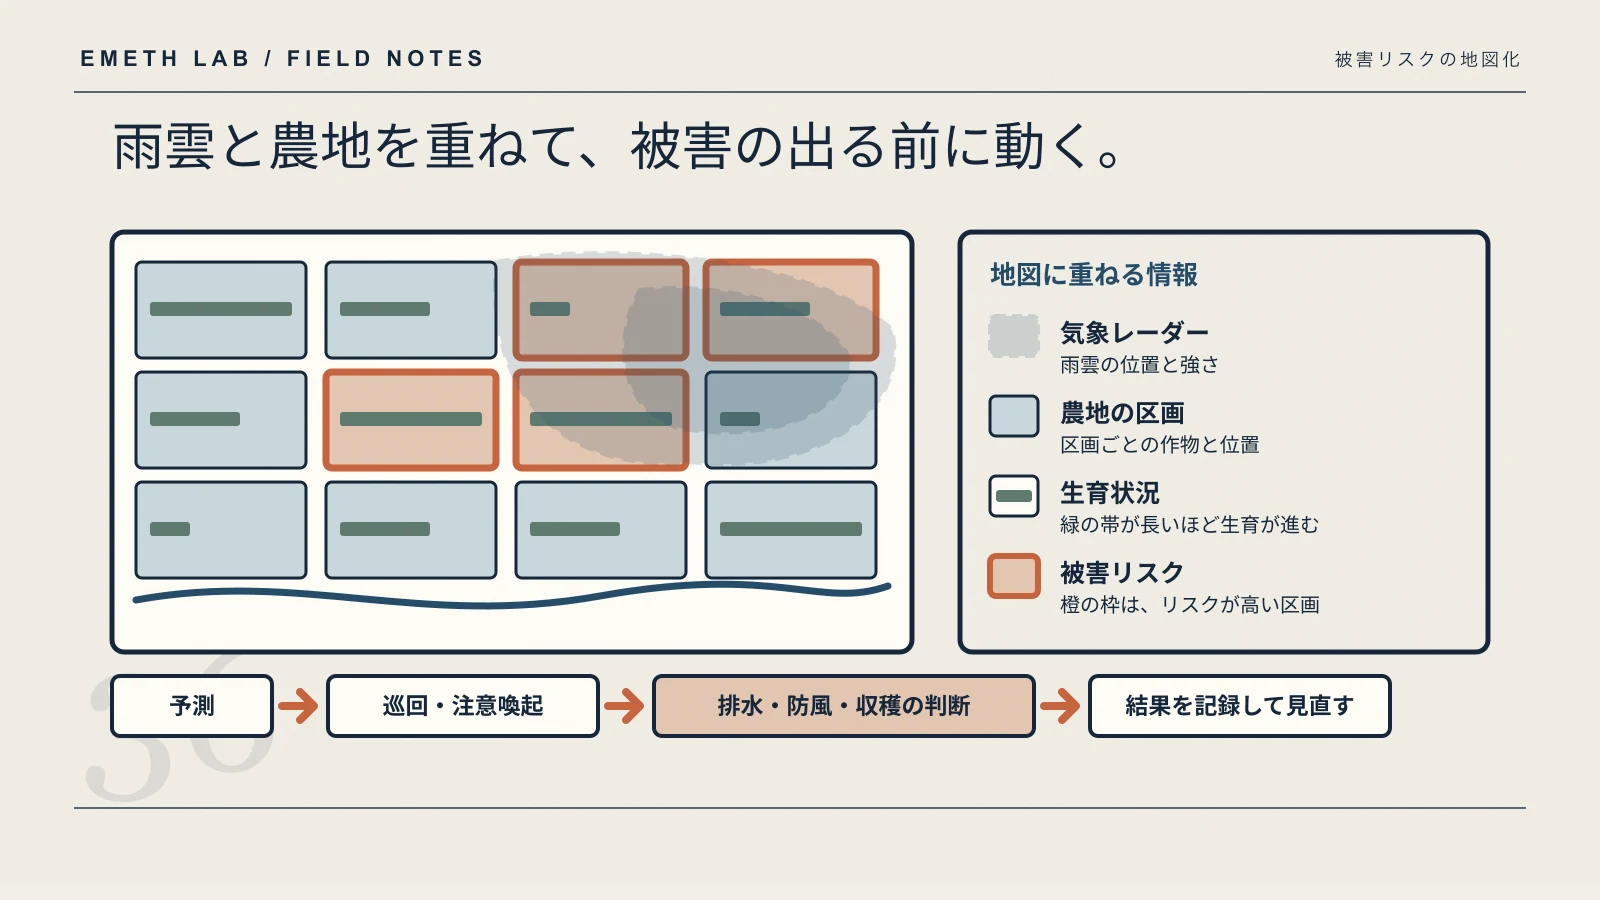
極端気象による農作物被害への対応では、被害が発生してから現地を確認するだけでなく、予報段階でリスクの高い地域や作物を把握することが重要です。気象情報、農業データ、過去の被害記録を組み合わせれば、巡回や注意喚起などの優先順位を検討しやすくなります。
ただし、予測結果は確定的な被害判定ではありません。気象予報の不確実性や地域ごとの地形・栽培条件を踏まえ、現場の判断を支援する情報として運用する必要があります。
最新動向
arXiv掲載論文(Yu, Dai, Wenほか、2026年10月)は、物理的に解釈できる気象指標を因果分析で吟味して農業ハザードを判定するエージェント「WxCrop」を提案しています。フロリダ州のハリケーン、凍結、乾燥高温を対象に、ハザードごとに保険記録で較正した損失モデルを使い、作物群ごとの損失を期待季節価値に対する割合で返します。数値にはすべて出典が付きます。
検証は3点です。ハリケーン指標は、記録された低気圧日をAUC 0.98で検出しました。評価用に除いた年の損失は、2%以内で再現しています。独立した生産量記録では郡の順位を確認しており、順位相関は0.63でした。
一方、公開された概要からは、生育段階、圃場単位の位置情報、予報更新履歴、標高・傾斜、排水施設との距離、巡回記録や防風対策の実施状況まで利用したことは確認できません。したがって、これらを同論文の実証内容として断定するのは避ける必要があります。
出典:From extreme weather to agricultural consequences with agentic AI
日本企業への示唆
日本で同様の仕組みを導入する場合、全国一律のモデルを目指すより、災害の種類、作物、地域を絞る方が現実的です。例えば、次のようなテーマが考えられます。
- 果樹産地における台風接近時の強風・落果リスク
- 露地野菜産地における豪雨後の冠水リスク
- 茶や果樹産地における霜害リスク
- 水田地帯における大雨後の浸水リスク
対象になり得るのは、農業法人、農業協同組合、自治体、農業保険関連事業者、農業向けシステムを提供するIT企業などです。特に、複数の生産者を管轄する農協や自治体では、地域単位のリスク一覧を作成することで、巡回や情報発信の優先順位を検討しやすくなります。
最初の1ステップは、過去の被害が比較的多く、対応策が明確な災害を一つ選び、対象地域と作物を限定した検証を始めることです。例えば、ある市町村の果樹園を対象に、台風接近時の最大風速、累積降水量、過去の落果記録を用いて、巡回候補地域を抽出します。
なお、保険対応の優先順位を決める用途については、保険記録を活用した研究例はあるものの、実際の保険業務でどのように優先順位を決めるかは、契約条件や査定手順を含めて個別に設計する必要があります。
前提と準備
農業災害の予測は、単に降水量や気温が閾値を超えたかを確認する仕組みではありません。作物の種類、生育段階、地域、過去の被害、気象予報などを組み合わせ、「どの地域の、どの作物が、どの程度影響を受ける可能性があるか」を推定します。
ただし、利用できるデータ項目は地域やシステムによって異なります。最初からすべてのデータをそろえるのではなく、予測対象に必要な項目から段階的に整備します。
準備するデータの例は次のとおりです。
- 気象観測値:気温、降水量、風速など
- 気象予報:台風、豪雨、低温、猛暑、霜などの予測値
- 農業データ:作物、品種、作付面積、播種日、収穫予定日、生育段階
- 地理データ:圃場または地域の位置情報
- 被害実績:被害地域、被害面積、収量減少、被害原因、復旧状況
- 対応データ:巡回や対策の実施状況を記録できる場合に利用
生育段階や圃場単位の位置情報は、すべての地域で取得できるとは限りません。圃場情報の整備が難しい場合は、町丁目、農協の管轄、行政区、メッシュなど、入手しやすい地域単位から始めます。
データを扱う環境としては、地理情報を表示できるダッシュボード、データを定期的に取り込む処理基盤、予測結果を保存するデータベースなどが考えられます。大規模なAI基盤を前提にせず、対象地域と作物を限定した小規模な検証から始める方法が実務上は取り組みやすいと考えられます。
手順
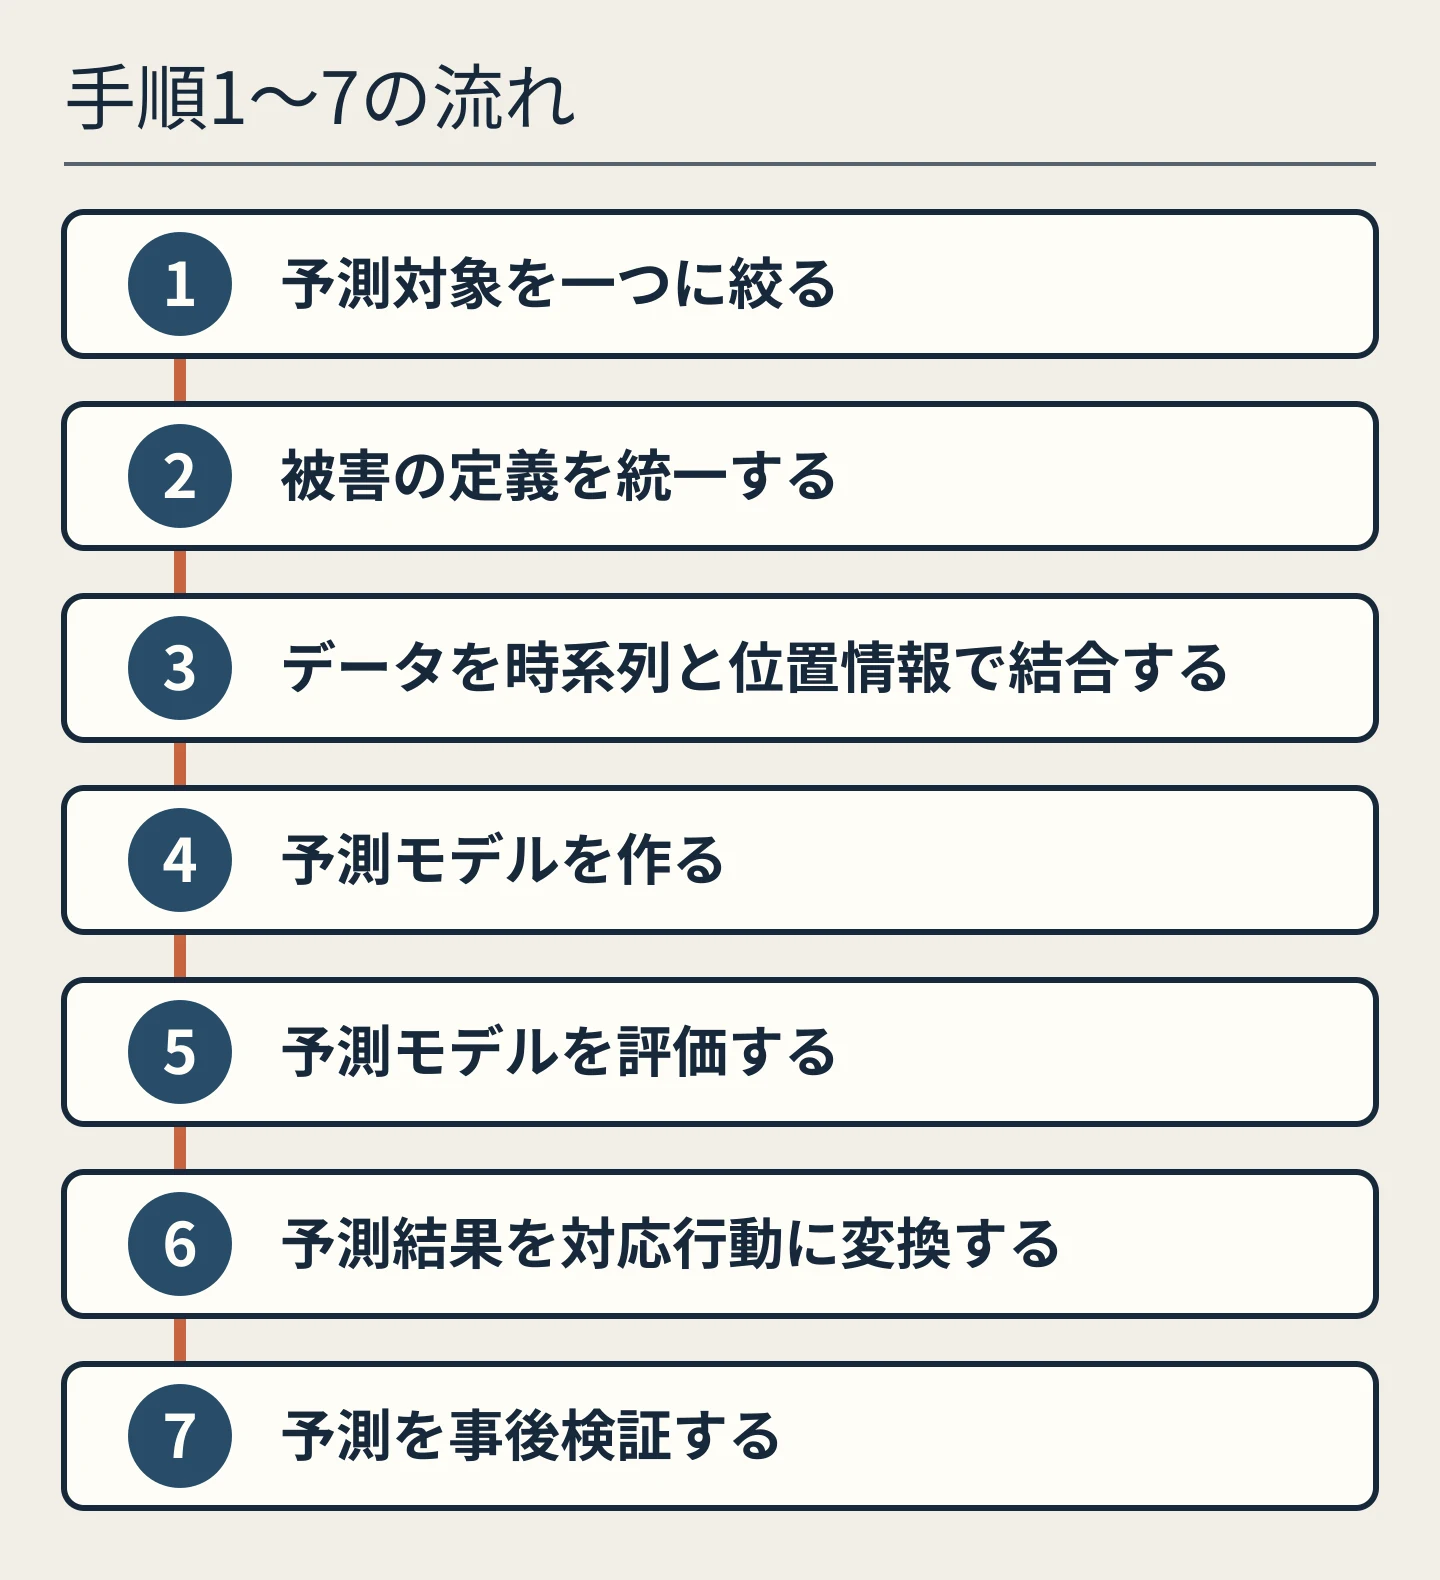
1. 最初に予測対象を一つに絞る
「農業被害全体」ではなく、「台風接近時の果樹落果リスク」や「豪雨後の水田冠水リスク」のように定義します。
対象を決める際は、次の3点を表にします。
| 項目 | 決める内容 |
|---|---|
| 災害 | 台風、豪雨、霜、猛暑など |
| 対象 | 作物、品種、生育段階、地域 |
| 予測結果 | 被害確率、被害面積、収量減少率など |
2. 被害の定義を統一する
「被害あり」を担当者の感覚に任せると、学習データや評価データの品質が下がります。例えば、冠水時間、収量の平年比、落果率など、記録可能な基準に変換します。
被害の有無だけでなく、被害の程度を複数段階で記録すると、巡回の優先順位を付けやすくなります。
| 区分 | 対応例 |
|---|---|
| 低 | 通常の監視 |
| 中 | 現地確認、農家への注意喚起 |
| 高 | 排水、防風、収穫前倒しなどの実施判断 |
基準値は作物や災害によって異なるため、農業担当者や現場の生産者と合意したうえで設定します。
3. データを時系列と位置情報で結合する
気象データ、圃場または地域データ、被害記録を、同じ地域単位と日時にそろえます。
特に、次の時刻を区別して記録することが重要です。
- 気象予報が発表された時刻
- 実際に観測された気象値の時刻
- 被害が発生または確認された時刻
- 作物の生育段階を記録した時点
- 対策を実施した時刻
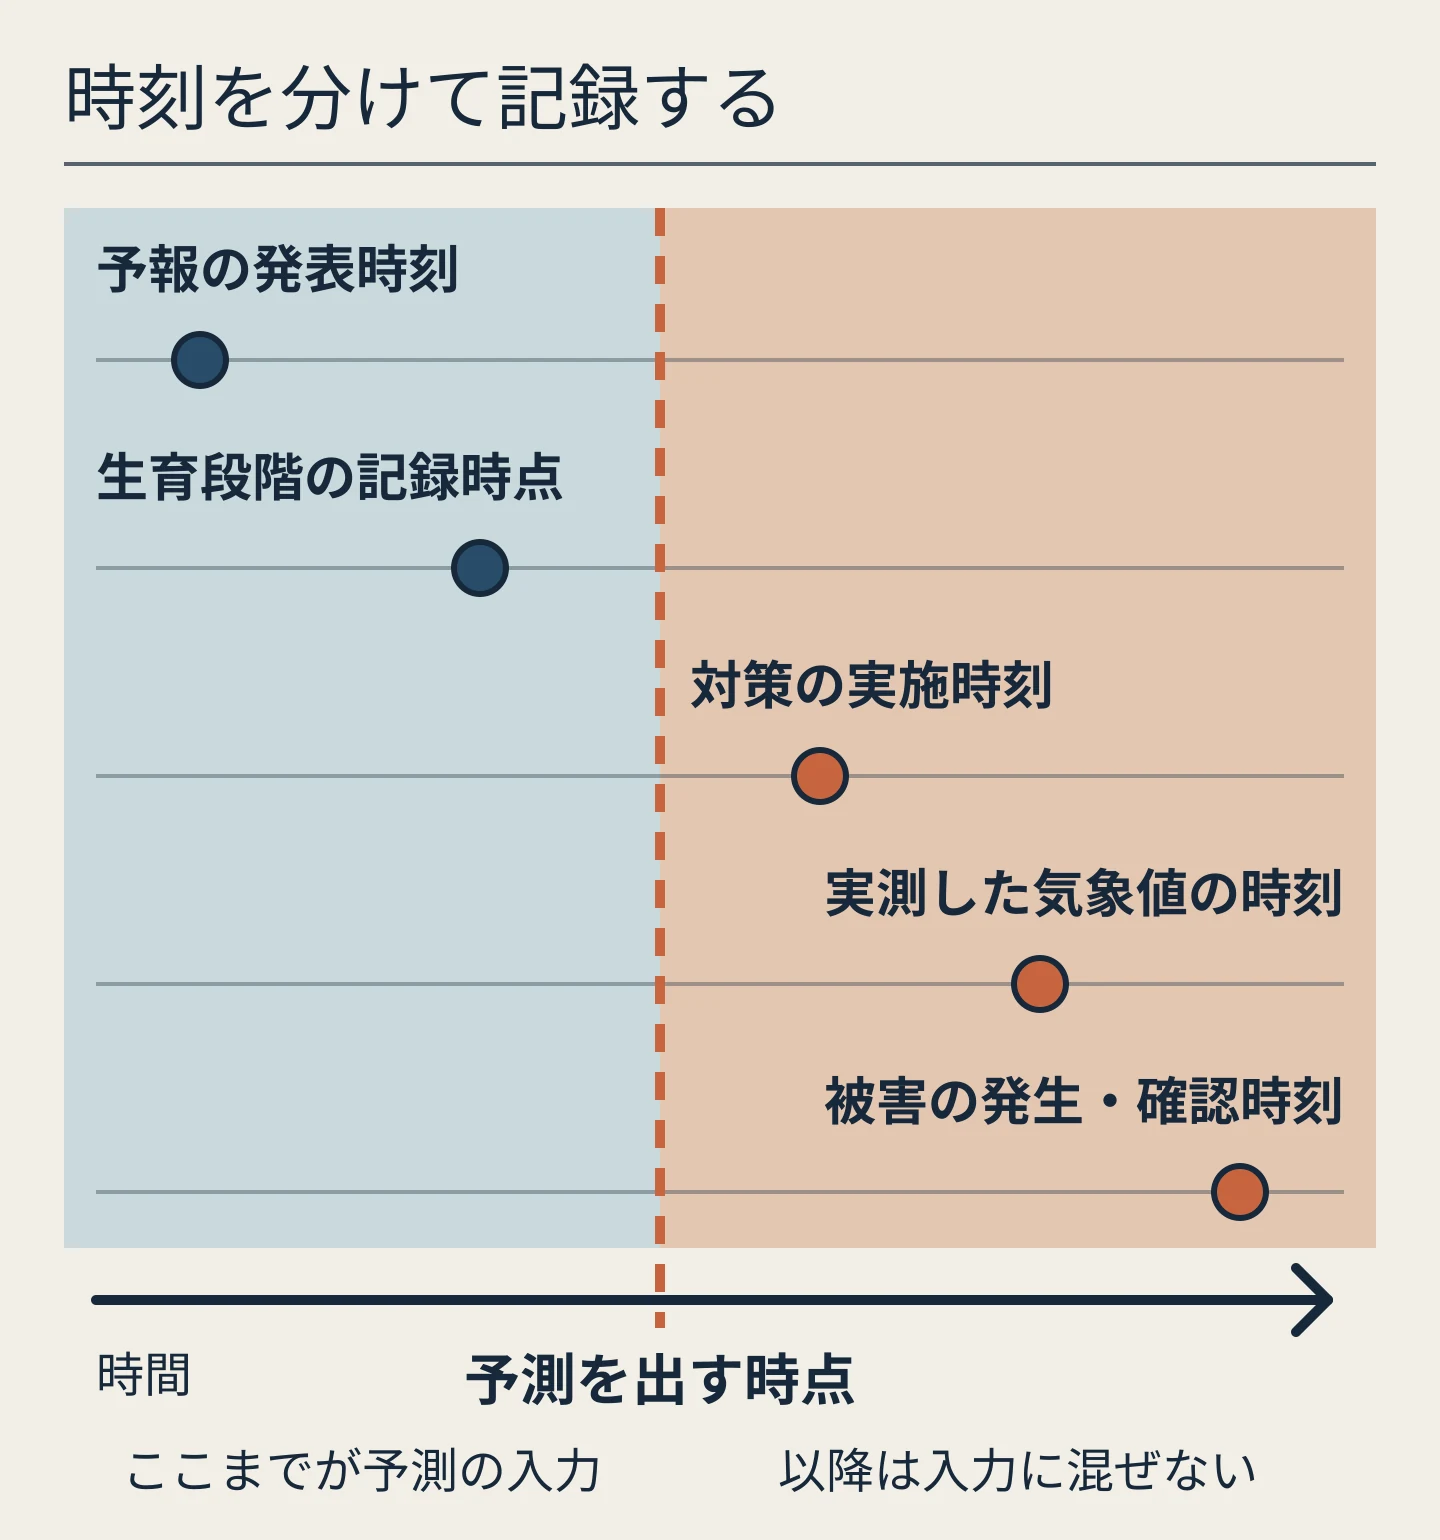
予報値と実測値を混同すると、災害前の予測性能を正しく評価できません。また、被害後にしか分からない情報を予測時点の入力に混ぜると、実運用よりも高い性能が出る可能性があります。
4. 予測モデルを作る
初期段階では、ロジスティック回帰、決定木、勾配ブースティングなど、説明しやすいモデルを候補にします。入力項目には、最大風速、累積降水量、連続降雨時間、最低気温、土壌水分、生育段階などが考えられます。
ただし、実際に利用する項目は、データの取得可能性と検証結果に基づいて決めます。公開情報だけでは、生育段階や土壌水分などが実証に使われたか確認できないため、特定の研究で利用された項目として断定しないようにします。
AIエージェントを採用する場合も、役割を分けて設計します。
- 気象予報を取得する
- 対象地域と作物を抽出する
- 過去の類似災害を検索する
- 予測モデルを実行する
- 根拠と不確実性を添えて結果を出力する
- 対応担当者へ通知する
生成AIに最終判断を任せるのではなく、数値予測、根拠データ、対応ルールを分離して管理します。
5. 予測モデルを評価する
災害データは、被害が発生しないケースが多くなりやすいため、正解率だけで評価すると実態を誤る可能性があります。少なくとも、次の指標を確認します。
- 適合率:高リスクと判定した地域のうち、実際に被害があった割合
- 再現率:実際に被害があった地域を、どれだけ高リスクとして検出できたか
- F1スコア:適合率と再現率のバランス
- ROC-AUCまたはPR-AUC:判定閾値を変えたときの識別性能
- 見逃し件数:高リスクでないと判定した被害の件数
- リードタイム:被害発生または確認の何時間前に通知できたか
- 対応実施率:通知を受けた地域で対策が実施された割合
評価時には、同じ災害のデータが学習用と評価用にまたがらないよう注意します。時系列データでは、過去の期間で学習し、将来の期間で評価する方法が実運用に近いと考えられます。
また、地域や作物ごとにデータ量が異なる場合は、全体の平均だけでなく、作物別・地域別の結果も確認します。高リスク判定の閾値は、誤警報のコストと重大被害の見逃しコストを比較して決めます。
6. 予測結果を対応行動に変換する
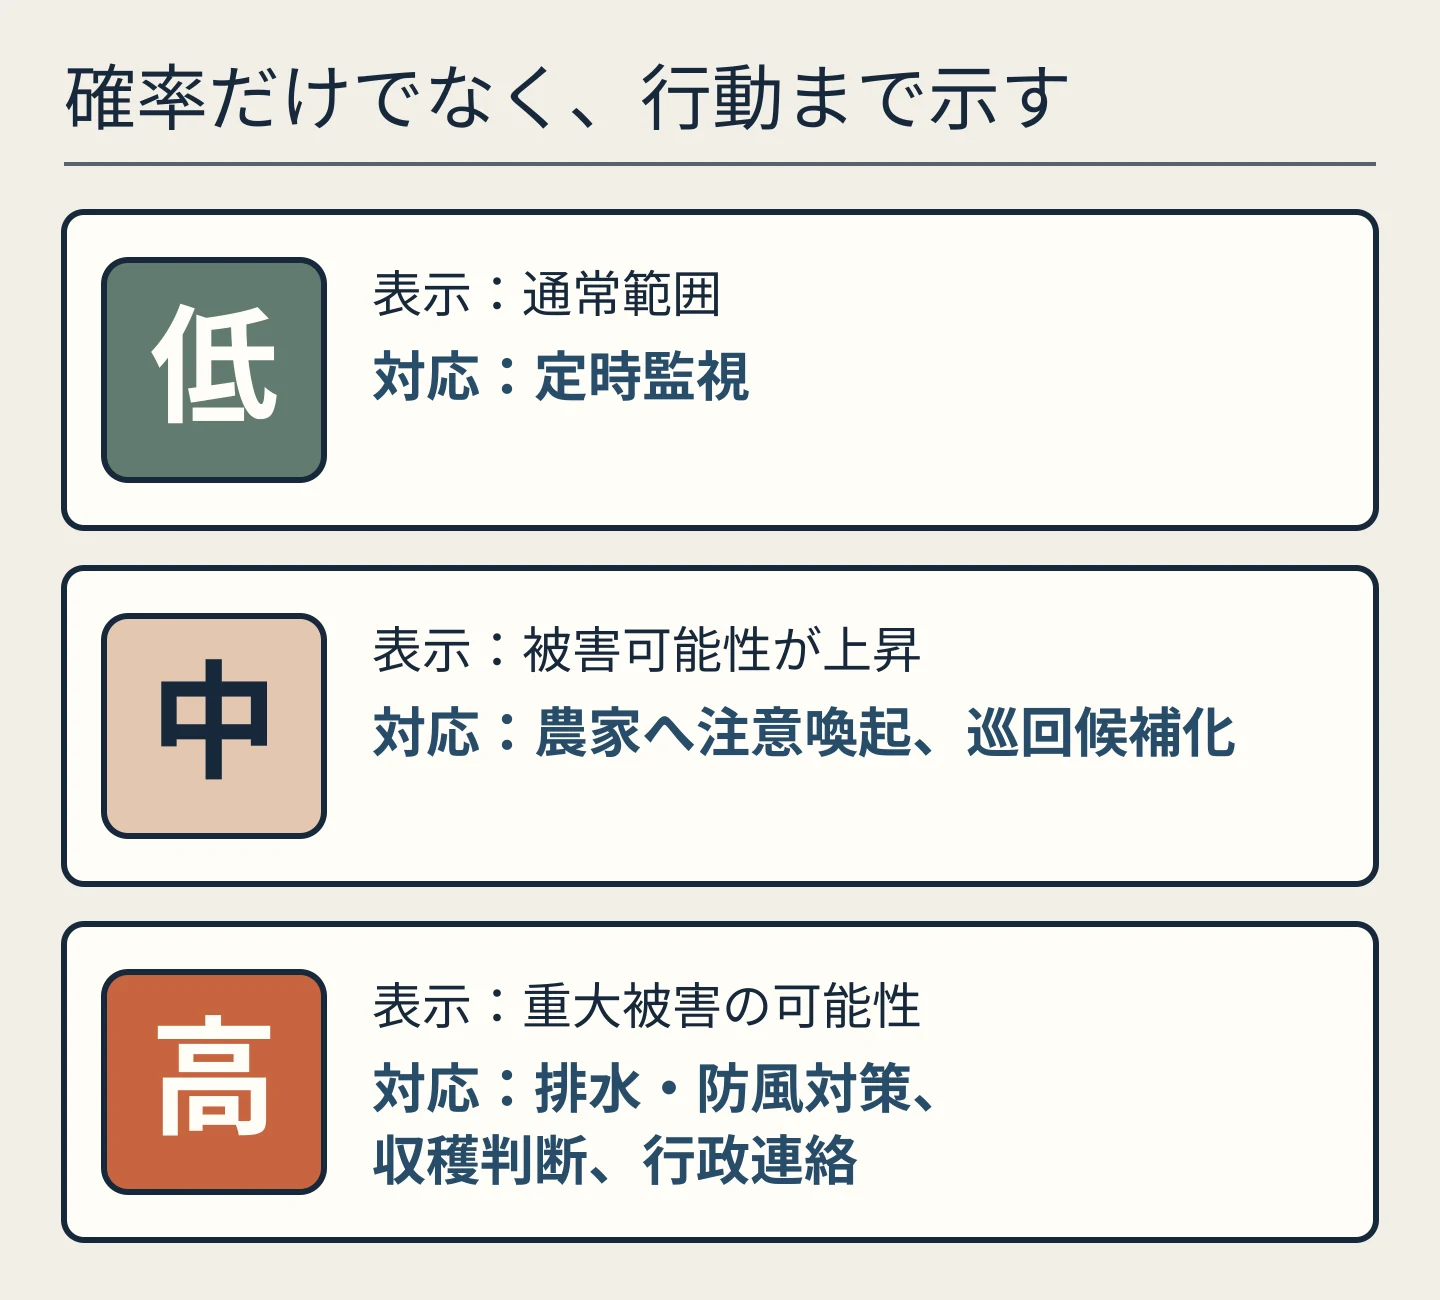
予測画面に確率だけを表示しても、現場は動けません。次のように、リスク区分と行動を結び付けます。
| リスク | 表示内容 | 対応 |
|---|---|---|
| 低 | 通常範囲 | 定時監視 |
| 中 | 被害可能性が上昇 | 農家へ注意喚起、巡回候補化 |
| 高 | 重大被害の可能性 | 排水・防風対策、収穫判断、行政連絡 |
通知には、次の情報を含めます。
- 対象地域
- 対象作物
- 予測時刻
- 主な要因
- 信頼区間または不確実性
- 推奨行動
- 予測の有効期限
予測結果が変化した場合に備え、通知の更新履歴や担当者の確認状況を記録すると、後から運用を検証しやすくなります。
7. 予測を事後検証する
災害後に、予測と実際の被害を比較します。高リスク判定が当たったかだけでなく、通知が現場の行動につながったかも確認します。
検証では、次の点を整理します。
- どの時点の予報を使ったか
- 予測時点で利用できたデータは何か
- 実際の被害はどの地域・作物で発生したか
- 通知から被害確認までにどれだけ時間があったか
- 推奨行動が実施されたか
- 対策によって被害の拡大を抑えられた可能性があるか
農業災害では、誤警報を減らすことだけでなく、重大被害の見逃しを防ぐことが重要です。指標の重みは、作物と災害ごとに決めます。
つまずきやすい点
データ不足とモデルの不安定さ
災害は頻度が低く、地域ごとの被害記録も限られます。複雑なモデルを急いで導入せず、複数年の記録を集め、類似地域や近隣自治体とのデータ連携を検討します。
予測結果を過信する
気象予報自体に不確実性があり、同じ雨量でも地域の条件によって被害は変わります。予測値を断定表現にせず、リスク区分、信頼度、主な要因を併記します。
現場対応との接続不足
ダッシュボードを作ることが目的になると、通知を受けた後の行動が決まりません。予測対象を選ぶ段階で、誰が、いつ、何をするかを対応表にしてください。
過去データの定義がばらばら
「一部被害」「甚大」などの自由記述だけでは比較できません。被害面積、収量減少率、冠水時間など、後から集計できる項目を追加します。
AIの説明が不十分
生成AIが作成した文章だけでは、行政判断や保険対応の根拠になりません。元の気象値、類似事例、モデルの判定理由を保存し、担当者が確認できる状態にします。
実行チェックリスト
- 対象とする災害、作物、地域を一つに絞った
- 被害の定義と記録単位を統一した
- 予報値と実測値を区別して保存している
- 気象データ、農業データ、被害記録を時刻と位置で結合できる
- 予測時点で利用可能な情報だけを入力にしている
- 適合率、再現率、見逃し件数、リードタイムを評価する
- 予測結果を低・中・高などの行動区分に変換した
- 通知に対象地域、主な要因、不確実性、推奨行動を含めた
- 予測と実際の被害を災害後に比較する
- 予測結果と対応履歴を保存している
- 現場担当者が予測の根拠を確認できる
まとめ
気象データを活用した農業災害予測では、AIを導入すること自体よりも、予測対象、被害の定義、データの時刻と位置、対応行動を一貫して設計することが重要です。
まずは、特定の地域と作物について、台風、豪雨、霜害など一つの災害を対象にします。次に、予報値と過去の被害記録を結合し、説明しやすいモデルで予測性能を検証します。そのうえで、低・中・高のリスク区分を巡回、注意喚起、排水、防風、収穫判断などの行動に結び付けます。
予測には不確実性があるため、最終判断を自動化するのではなく、現場担当者が根拠を確認しながら対応できる仕組みにすることが大切です。小さな対象から検証し、実際の対応結果を記録して改善を重ねることで、農業災害への備えをより実務的なものにできます。