はじめに
社内に分散した文書や業務データを整理し、自然言語で必要な情報を探せる状態を作る方法を解説します。AI検索を導入する際に検討される、データ基盤の設計、検索精度の改善、権限管理、現場定着までの進め方を、段階的にまとめます。
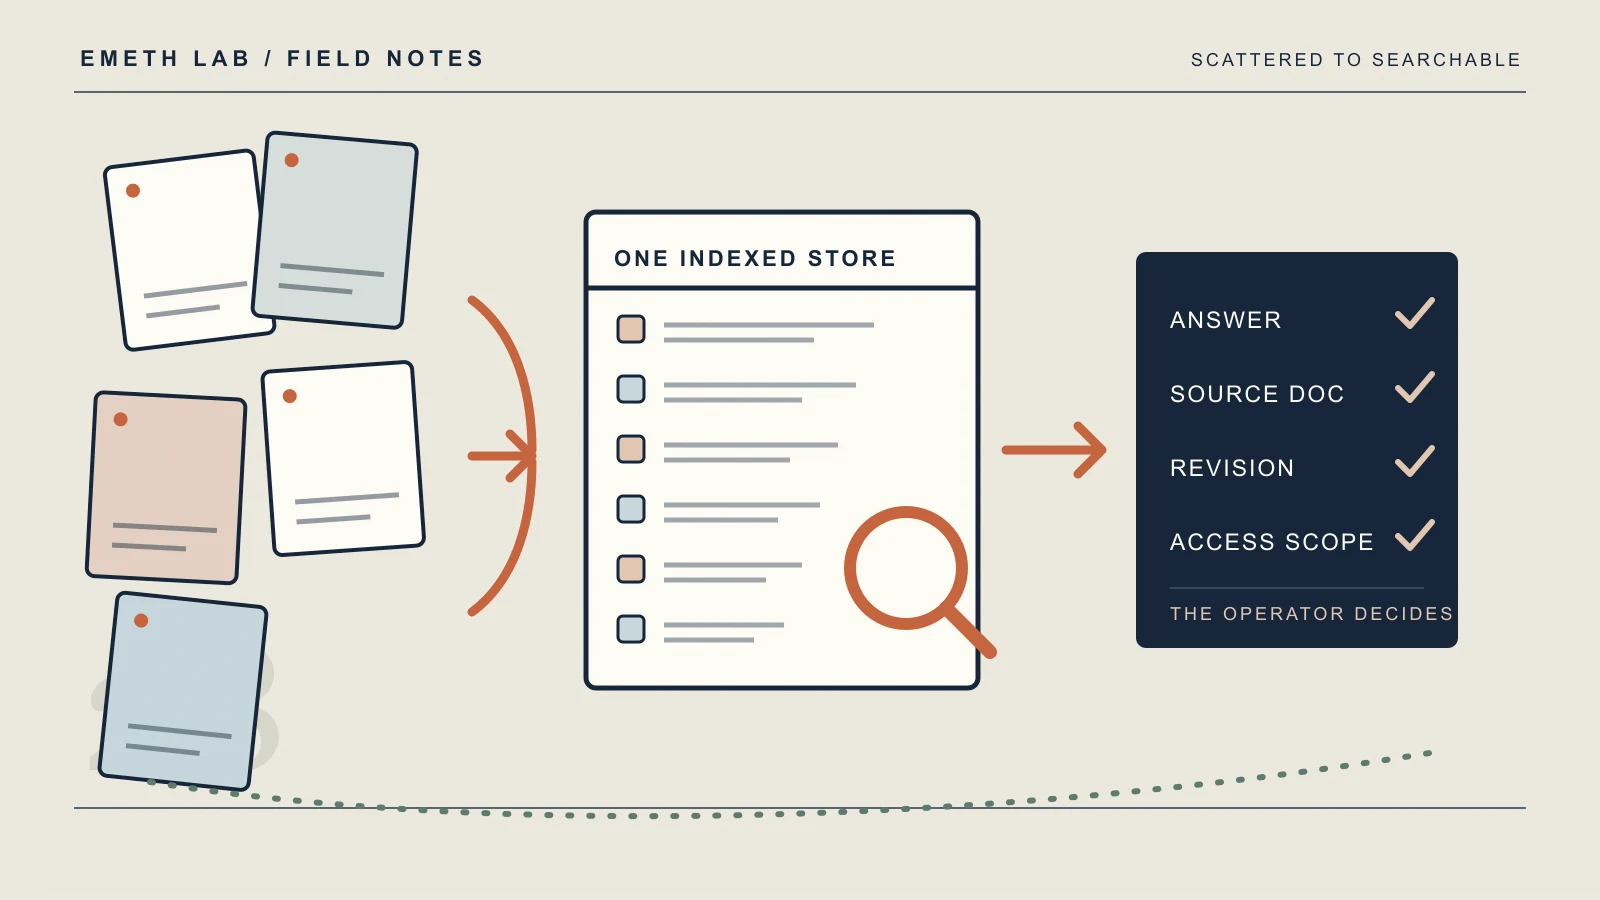
AI検索は、生成AIを導入するだけで期待どおりに機能するとは限りません。検索対象となるデータを集約または連携し、内容を読み取りやすく整え、利用者ごとのアクセス権を適切に反映する設計が必要です。
最新動向
企業では、社内に蓄積された文書を自然言語で検索し、必要なファイルを見つけやすくする取り組みが進められているとされています。
@ITの記事では、AWSが社内に散在していた約29万ファイルをAmazon S3に集約し、AIを使って自然言語でファイルを検索できる仕組みを構築した取り組みが紹介されています。
- 媒体:@IT(アイティメディア)
- 出典:散在する29万ファイルをAmazon S3に集約しAI検索を実現したAWSの仕組み
- 記事公開日:2026年9月18日
この事例からは、大量のファイルを一つの保管先に置くだけでなく、検索対象として扱える形式に整え、利用者が必要な情報へ到達しやすくすることが重要だと考えられます。ただし、公開情報だけでは、検索精度の具体的な測定方法や利用者ごとの権限設計、現場定着の手順までは確認できない場合があります。自社で導入する際は、これらを別途設計する必要があります。
手順
1. 検索対象を一つの業務に絞る
最初から全社のデータを対象にすると、権限、データ品質、評価方法が複雑になります。まずは、検索による効果を測りやすい業務を一つ選びます。
候補には次のようなものがあります。
- 製造業の設備トラブル記録や保全手順書
- 化学業の安全資料や品質異常報告書
- エネルギー業の点検記録や運転手順書
- 水処理事業の設備仕様書や薬品管理記録
選定時は、次の3項目を5段階で評価します。
| 評価項目 | 確認内容 |
|---|---|
| 検索頻度 | 現場が日常的に探しているか |
| 探索時間 | 現在、情報を探すのに時間がかかっているか |
| データの整備度 | 文書が電子化され、一定の命名規則があるか |
合計点が高く、かつ安全性や法令判断をAIに単独で任せない業務から始めます。
2. データの所在と権限を棚卸しする
利用するデータの保存場所、所有部門、更新日、機密区分、アクセス権を一覧化します。対象システムは企業ごとに異なるため、実際の環境を確認したうえで決めてください。
候補としては、ファイルサーバー、クラウドストレージ、文書管理システム、グループウェアなどが考えられます。ERP、CRM、設備管理システム、メール、議事録を対象に含める場合は、データの正確性、保存期間、個人情報、アクセス権を個別に確認します。
最低限、次の項目を表にしてください。
| 項目 | 例 |
|---|---|
| データID | 一意の管理番号 |
| 保存場所 | ファイルサーバー、クラウドストレージ、業務システム |
| データ種別 | PDF、Excel、画像、メール |
| 所有者 | 部門長またはデータ管理責任者 |
| 更新日 | 最終更新日 |
| 機密区分 | 公開、社内限定、機密 |
| 利用期限 | 保管期限や廃棄予定日 |
| アクセス権 | 閲覧可能な部門、役職、個人 |
この段階で、重複ファイル、古い版、所有者不明の文書を分けます。古い情報を検索対象に残すと、AIが誤った手順を回答する原因になり得ます。
3. 保管先と取り込み方式を決める
文書を集約する保管先には、クラウドストレージ、データレイク、文書管理システムなどがあります。選定では、容量だけでなく、次の機能を確認します。
- APIでデータを取り込めるか
- 文書の更新を検知できるか
- 暗号化とバックアップに対応しているか
- 利用者の権限を検索結果に反映できるか
- 操作ログを保存できるか
- 削除や利用期限を検索インデックスにも反映できるか
既存システムをすべて移行する必要はありません。検索基盤にコピーを作る方式、メタデータだけ連携する方式、元システムを参照する方式を、データ種別ごとに選びます。
4. 文書を検索用に加工する
AI検索では、ファイルを保存するだけでなく、本文を抽出して検索単位に分割します。PDF、表計算、画像、スキャン文書では処理方法が異なります。
具体的には次を実施します。
- OCRで画像やスキャン文書から文字を抽出する
- 文書の見出し、表、段落を認識する
- 長い文書を意味のまとまりごとに分割する
- 文書ID、部門、設備、日付などのメタデータを付与する
- 更新版と旧版を識別する
- 機密区分とアクセス権を検索インデックスに反映する
分割が細かすぎると文脈が失われ、粗すぎると検索結果が不正確になる可能性があります。最初は見出しや段落単位で設定し、評価結果を見ながら調整します。
5. 権限設計を検索処理に組み込む
権限管理は、検索基盤を作った後に追加するのではなく、データ取り込みの段階から組み込みます。利用者が閲覧できない文書を、検索結果や回答の根拠として表示しない仕組みが必要です。
最低限、次のルールを決めます。
- 元システムのアクセス権を検索基盤へ同期する
- 部門、役職、拠点、案件などの単位で閲覧範囲を定義する
- 異動、退職、組織変更時の権限更新手順を決める
- 機密情報や個人情報を検索対象から除外する基準を設ける
- 検索ログと回答ログの閲覧者を限定する
- 権限外データが表示されないことを定期的にテストする
特に、検索結果のタイトルや抜粋だけでも機密情報が漏れる可能性があります。回答本文だけでなく、検索結果、引用箇所、文書リンクにもアクセス制御を適用します。
6. 自然言語検索と回答生成を分けて設計する
利用者の質問に対して、まず関連文書を検索し、その後に生成AIが回答を作る構成にします。検索を経ずに生成AIへ質問すると、社内文書に基づかない回答が混ざる可能性があります。
回答画面には、次の情報を表示します。
- 回答本文
- 参照した文書名
- 該当ページや段落
- 文書の更新日
- 回答の確信度または注意表示
- 文書を開くリンク
現場利用では、「もっともらしい回答」より「根拠を確認できる回答」を優先する設計が適しています。特に製造、エネルギー、化学などでは、AIの回答だけで作業判断を完結させない運用が必要です。
7. 代表質問と正解データで精度を評価する
実際の利用者から30〜50個程度の質問を集め、質問ごとに正解となる文書や回答の条件を整理します。公開情報からは、このような評価データの準備方法までは確認できないため、自社の業務に合わせて作成します。
評価用データには、次の項目を含めます。
| 項目 | 内容 |
|---|---|
| 質問 | 現場で実際に使われる表現 |
| 想定利用者 | 部門、役職、拠点 |
| 正解文書 | 参照すべき文書IDやURL |
| 必須条件 | 回答に含めるべき情報 |
| 禁止条件 | 表示してはいけない情報 |
| 最新版 | 優先すべき版や更新日 |
| 許容時間 | 回答までに許容できる時間 |
評価項目は次のとおりです。
- 正しい文書が上位に表示されたか
- 回答に根拠があるか
- 最新版を参照しているか
- 権限外の情報が表示されていないか
- 回答までの時間が許容範囲か
- 「分からない」と回答すべき質問で無理に断定していないか
検索精度は、正解文書が上位何件に含まれるかで測定できます。回答品質は、現場責任者が「そのまま使える」「確認が必要」「誤り」の3段階で判定すると、改善箇所を特定しやすくなります。
8. 小規模な利用者で試し、運用を定着させる
最初は一つの部門、拠点、または業務チームに限定します。利用ログから、検索される言葉、失敗する質問、参照される文書を確認します。
改善対象は、AIモデルだけではありません。
- 文書タイトルの付け方
- 文書の版管理
- メタデータの不足
- 古い文書の廃棄
- 利用者向けの質問方法
- 回答を確認する責任者
- 権限設定の誤り
- 検索結果に表示されない文書の原因
運用開始後は、月次で検索失敗率、利用回数、回答の修正件数、権限エラーを確認します。重大な誤回答や権限漏れが発生した場合は、原因を記録し、データ、検索設定、権限、利用者教育のどこに問題があったかを切り分けます。
日本企業への示唆
日本企業で導入する場合は、全社一斉展開よりも、業務範囲と利用者を限定した試行が適しています。特に、製造業の中堅企業であれば、最初の1ステップとして「一つの工場にある設備トラブル記録と保全手順書を棚卸しし、最新版と閲覧権限を整理する」方法が考えられます。
化学メーカーであれば安全資料や品質異常報告書、エネルギー企業であれば点検記録や運転手順書など、検索頻度が高く、文書の所在を把握しやすい領域から始めると評価しやすくなります。
導入時は、次の役割を明確にしてください。
- 業務部門:検索対象と正解データを決める
- 情報システム部門:取り込み、検索、ログ、セキュリティを管理する
- データ管理責任者:文書の所有者、保存期限、版管理を決める
- 現場責任者:回答を業務で利用できるか評価する
- セキュリティ・法務部門:個人情報や機密情報の扱いを確認する
AI検索を単なるチャットツールとして導入するのではなく、文書管理、権限管理、業務手順の見直しと一体で進めることが重要です。
つまずきやすい点
データを集めれば検索できると思う
ファイルを一か所にコピーしても、重複や旧版が残っていれば検索品質は上がりません。所有者、更新日、版番号、機密区分を付与し、検索対象外にする文書を決めます。
権限管理を後回しにする
検索結果には、文書本文だけでなくタイトル、抜粋、更新日、リンクが表示される場合があります。権限外の文書が検索結果に現れないよう、取り込み時点からアクセス制御を適用します。
評価を感覚だけで行う
「便利そう」「回答が自然」といった印象だけでは、検索品質を継続的に改善できません。代表質問、正解文書、最新版、許容時間を定義し、同じ条件で定期的に評価します。
AIの回答をそのまま業務判断に使う
AIが誤ったり、古い文書を参照したりする可能性は残ります。安全、品質、法令、設備操作に関わる回答では、必ず原文を確認し、必要に応じて担当者が判断する手順を設けます。
現場への説明が不足する
利用者が質問方法や回答の確認方法を理解していなければ、検索基盤は定着しません。導入時には、質問例、根拠文書の確認方法、誤回答の報告先、利用してはいけない用途を説明します。
まとめ
AI検索を活用するには、生成AIを導入するだけでなく、検索対象となるデータを整理し、文書を検索しやすい単位に加工し、権限を正しく反映する必要があります。
進め方の要点は次のとおりです。
- 効果を測りやすい一つの業務から始める
- データの所在、所有者、更新日、権限を棚卸しする
- 保管先と取り込み方式をデータ種別ごとに決める
- OCR、文書分割、メタデータ付与を行う
- 検索と回答生成を分け、根拠を表示する
- 代表質問と正解データで精度を評価する
- 小規模な利用者で試し、ログと現場の声で改善する
- 権限管理と人による確認を運用に組み込む
まずは、検索頻度が高く、文書の所有者と最新版を確認しやすい業務を一つ選び、データ棚卸しから始めるとよいでしょう。