はじめに
生成AIやAIエージェントを導入した企業向けに、推論費用をモデル別・業務別に分解し、GPUとクラウドの利用効率、1処理当たりの採算、改善優先順位を判断する方法を解説します。
生成AIの導入では、モデルの精度や回答品質に注目が集まりがちです。しかし、利用量が増えると、API料金、GPU、ストレージ、ネットワーク、監視などの費用が積み上がります。特にAIエージェントは、1回の依頼で複数回の推論を実行するため、利用者数だけではコストを予測できません。
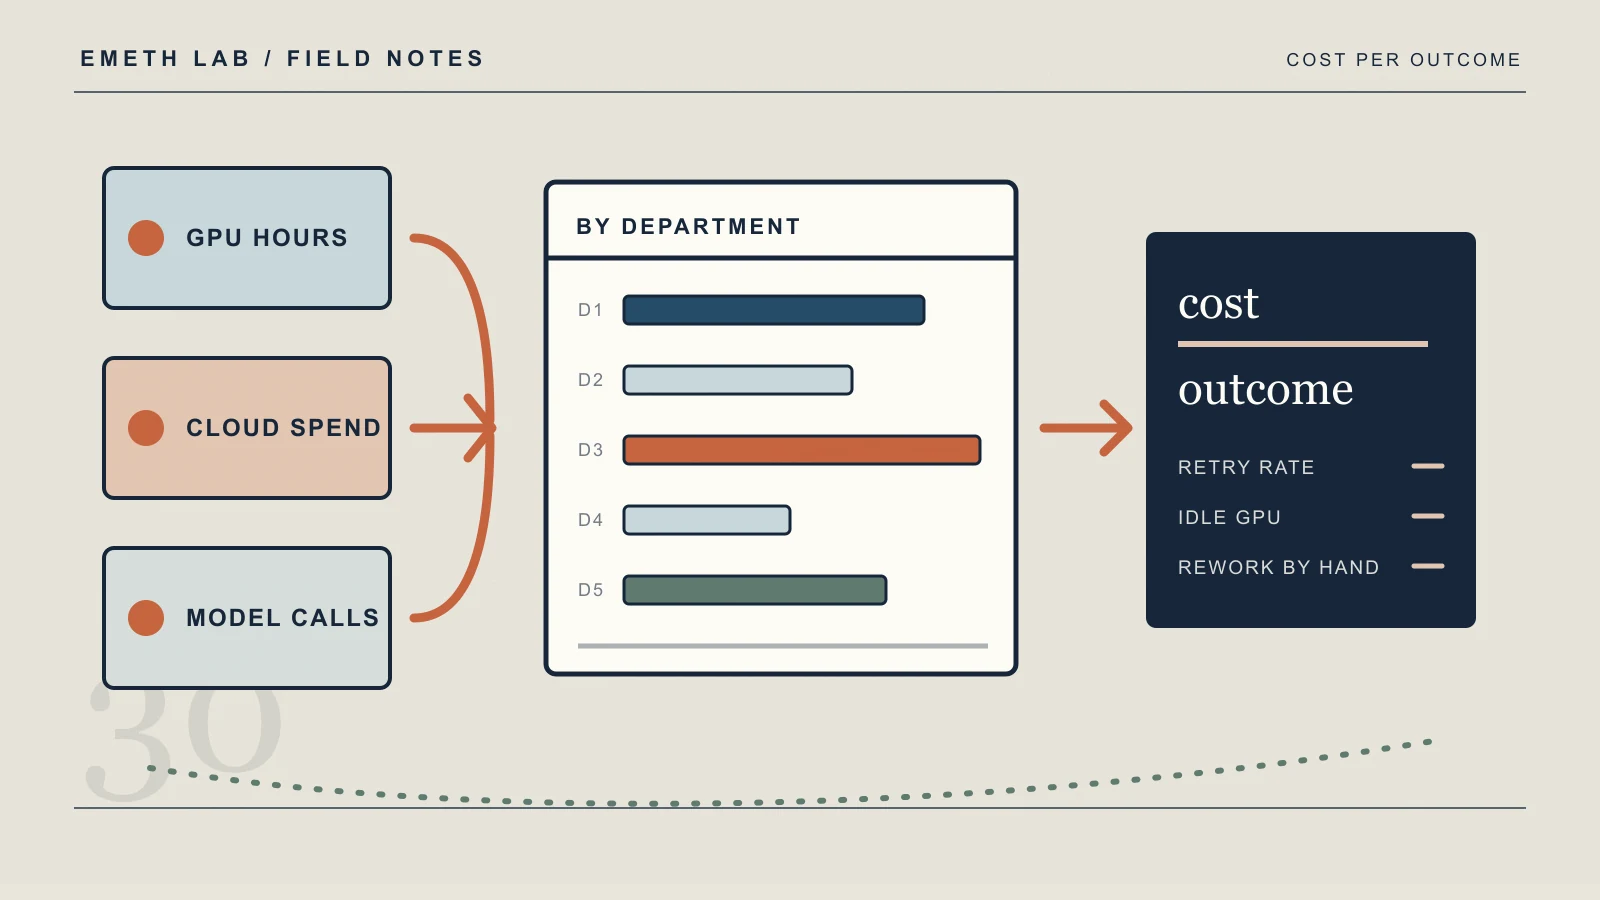
問題は、請求書の金額だけでは「どの業務が、どのモデルを、どれだけ使ったか」が分からないことです。採算管理には、インフラ費用を業務単位の原価へ変換する仕組みが必要です。
最新動向
AI推論基盤では、GPUを効率的に割り当てるためのオーケストレーションが重視されています。サターン・クラウドは、AIインフラの管理と推論ワークロードの効率化を目的に、NVIDIA Run:aiを統合したと報じられました。
- 媒体:Engineering.com
- 出典:Saturn Cloud integrates NVIDIA Run:ai for AI inference
- 記事公開日:2026年9月18日
一方、VercelのAI Gatewayでは、処理トークン数の過半数をオープンウェイトモデルが占める一方、支出の64%はAnthropicが占めていると報じられています。
この数値からは、トークン数の構成比と支出の構成比が一致しない場合があると考えられます。したがって、コスト分析ではトークン数だけでなく、モデルごとの単価、入力・出力の内訳、処理方式を分けて確認する必要があります。
- 媒体:The New Stack
- 出典:Open-weight models now handle a majority of tokens on Vercel’s AI Gateway. But Anthropic still takes 64% of the spend.
- 記事公開日:2026年9月18日
また、Kubernetes上でAI推論を実行する場合、GPUの割り当て、アイドル時間、共有利用、CPUやメモリなどの周辺リソースが関係します。そのため、単純にGPUの稼働時間だけを集計しても、実際の業務原価を正確に把握できない場合があるとされています。
- 媒体:The New Stack
- 出典:Kubernetes can run AI inference. But can it count the real cost?
- 記事公開日:2026年9月18日
推論コストを構成要素に分解する
まず、推論コストを次の4層に分けます。
| 層 | 主な費用 | 確認する単位 |
|---|---|---|
| モデル | API料金、モデル提供費 | 入力・出力トークン、リクエスト |
| 計算資源 | GPU、CPU、メモリ | GPU秒、Pod時間、ノード時間 |
| データ基盤 | ベクトルDB、ストレージ、検索 | クエリ数、容量、転送量 |
| 運用 | 監視、ログ、セキュリティ、保守 | 利用者、環境、月次固定費 |
API型では、入力トークンと出力トークンを記録し、モデル単価を掛けます。自社GPU型では、GPUの時間単価に稼働時間を掛けるだけでは不十分です。実際の処理時間、割り当て時間、アイドル時間を分けなければ、利用効率を評価できません。
最初に作るべき指標は、「1リクエスト当たりの費用」ではなく、「業務完了当たりの費用」です。AIエージェントでは、1つの業務が複数の推論、検索、ツール呼び出しで構成されるためです。
基本式は次のとおりです。
業務完了単価
=(モデル費用 + GPU費用 + データ基盤費用 + 運用費用)
÷ 完了した業務件数
さらに、業務単位の原価を比較する場合は、次の指標も有効です。
1件当たりモデル費用
= モデル費用 ÷ 完了した業務件数

GPU利用効率
= 実際のGPU処理時間 ÷ GPU割り当て時間

再処理率
= 再試行・人手修正が発生した件数 ÷ 総処理件数
可視化に必要なデータ設計
コストを業務へ紐付けるには、すべての推論リクエストに共通の識別情報を付与します。最低限、次の項目をログに持たせます。
- 部門、業務、アプリケーション
- 利用者または契約単位
- モデル名とモデルバージョン
- 入力・出力トークン数
- 推論時間とGPU時間
- 成功、再試行、タイムアウトの状態
- 検索や外部ツールの呼び出し回数
- 品質評価や人手修正の有無
- リクエストID、業務ID、エージェント実行ID
Kubernetesを使う場合は、Namespace、Pod、GPU、ワークロード、環境をコスト配賦のキーにします。GPUを専有している場合は割り当て時間を基準にし、共有している場合はGPU使用時間やメモリ使用量など、実態に近い配賦ルールを定義します。
共有GPUでは、単純な割り当て時間だけでは、複数ワークロード間の実際の利用差を表しにくい場合があります。一方で、細かい使用量ベースの計測には監視基盤の整備が必要です。まずは専有・共有の区分を明確にし、月次で配賦ルールを見直す方法が現実的です。
重要なのは、ダッシュボードを作ること自体ではありません。経理上の請求額と、現場が改善できる運用指標を同じ体系で接続することです。
改善施策の判断軸
コスト削減は、単価の安いモデルへ移行するだけでは成立しません。品質、遅延、可用性を含めて判断します。
| 施策 | 効果が出やすい条件 | 注意点 |
|---|---|---|
| 小型モデルへの切り替え | 定型分類、要約、抽出 | 品質低下と再処理を確認 |
| ルーティング | 問い合わせ難度に差がある | 判定ロジックの監視が必要 |
| キャッシュ | 類似質問や定型応答が多い | 情報の鮮度を管理 |
| バッチ処理 | 即時性が不要 | 業務時間との整合が必要 |
| GPU共有 | 利用時間に空きがある | 干渉と性能劣化を測定 |
| プロンプト削減 | 固定指示が長い | 回答品質への影響を検証 |
| 再試行抑制 | タイムアウトや失敗が多い | 障害原因の特定が先 |
KPIは、コストだけでなく品質と生産性を併記します。例えば、業務完了単価、1ユーザー当たり月額、GPU稼働率、GPUアイドル率、平均応答時間、再試行率、正答率、人手修正率です。
特に注意したいのは、GPU稼働率が高ければ良いとは限らない点です。キューが長くなり、応答時間や業務処理量が悪化している場合、コスト効率は改善していません。「費用/業務成果」と「品質/時間」を同じ画面で確認できる状態が、採算管理の最低条件です。
改善施策は、次の順番で検証すると進めやすくなります。
- 業務完了単価と品質を現状測定する
- コストの大きいモデル、業務、時間帯を特定する
- 小型モデル、キャッシュ、プロンプト削減など単一施策を試す
- 品質、応答時間、再処理率を変更前後で比較する
- 効果が確認できた施策を対象業務へ展開する
日本企業への示唆
製造業
製造業では、設備保全記録の検索、異常報告の要約、作業手順の照会など、定型性の高い業務から計測を始めやすいです。
最初の1ステップは、1つの工場または保全チームを対象に、1週間分のリクエストへ次の項目を付与することです。
- 設備またはライン
- 業務種別
- 使用モデル
- 入力・出力トークン
- 処理時間
- 人手修正の有無
これにより、設備単位や業務種別ごとの原価と品質を比較できます。
金融・保険
金融機関や保険会社では、顧客対応、稟議書の要約、約款検索、事故受付の補助などで品質要件が厳しくなりやすいです。単価削減を先行させるのではなく、モデル別の正答率、再処理率、人手確認時間を比較する必要があります。
最初の1ステップとして、1つの文書業務を選び、モデル変更前後で「1件当たり費用」「確認に要した時間」「修正率」を測定します。コストが下がっても確認作業が増える場合、実質的な業務原価は下がっていない可能性があります。
物流・運輸
物流会社では、問い合わせ対応、配車補助、納品状況の確認、倉庫内の作業指示などを対象にできます。利用者数ではなく、1案件または1問い合わせの完了単価を測ることが重要です。
最初の1ステップは、問い合わせ対応を対象に、1件ごとの推論回数、検索回数、外部ツール呼び出し回数、対応完了までの時間を記録することです。AIエージェントが複数回の推論を行っている場合、どの処理がコストを押し上げているかを特定できます。
小売・EC
小売やECでは、商品問い合わせ、返品受付、商品説明の生成、需要予測の補助などが候補になります。問い合わせの種類によって必要なモデル性能が異なるため、定型質問と複雑な相談を分けてルーティングすると、品質を維持しながら費用を抑えられる可能性があります。
最初の1ステップは、問い合わせを「定型」「商品比較」「個別判断が必要」などに分類し、カテゴリ別にモデル費用と解決率を比較することです。
企業規模別の進め方
大企業は、クラウド、データセンター、部門別予算が分かれやすいため、共通のコストタグと月次の配賦ルールを先に決めます。部門ごとに異なる計算方法を採用すると、全社比較が難しくなるためです。
中小企業は、全社的な基盤構築から始めず、APIの利用明細と業務件数を表計算で突合する方法が現実的です。まずは1つの業務について、月額費用と完了件数を記録します。
スタートアップは、顧客別・機能別の推論原価を早期に持ち、売上総利益を確認できる設計にします。特に、無料プランや従量課金プランでは、顧客ごとの推論回数と売上を紐付けることが重要です。
実行チェックリスト
- 推論費用をモデル別、業務別、部門別に分けている
- 入力・出力トークンとモデル単価を記録している
- 自社GPUの割り当て時間と実稼働時間を区別している
- GPUアイドル率と再試行率を把握している
- AIエージェントのツール呼び出し回数を記録している
- 業務IDとリクエストIDを紐付けている
- 1リクエスト当たりではなく、業務完了当たりの費用を計算している
- コスト、品質、応答時間を同じKPI体系で見ている
- モデル変更前後の品質と人手修正率を比較している
- 出典、集計期間、配賦ルールを記録している
まとめ
AI推論コストを正確に把握するには、請求書の金額を確認するだけでは不十分です。モデル費用、GPUやCPUなどの計算資源、データ基盤、監視・運用費を分解し、業務IDを使って業務単位へ紐付ける必要があります。
特にAIエージェントでは、1回の依頼が複数の推論、検索、ツール呼び出しに分かれます。そのため、利用者数やリクエスト数だけでなく、業務完了単価、再試行率、人手修正率まで確認することが重要です。
実務では、最初から全社のコスト管理基盤を構築する必要はありません。まずは1つの業務を選び、1週間分のリクエストについて、モデル、トークン、GPU時間、処理結果、業務完了件数を記録します。その後、小型モデル、ルーティング、キャッシュ、バッチ処理、GPU共有などを一つずつ検証します。
コスト削減の成否は、単価の低下だけで決まりません。品質、応答時間、再処理、人手確認を含めた「業務成果当たりの費用」で評価することが、持続的なAI運用と採算管理につながります。