はじめに
生成AIや業務エージェントを導入した後は、導入前より業務が改善したかを継続的に確認する必要があります。回答品質の変化、モデルや設定の変更による差、処理時間、費用、担当者の修正負荷などを同じ評価軸で比較できれば、感覚ではなくデータに基づいて改善や更新を判断できます。
本記事では、実業務に近い評価データを用意し、品質・速度・費用・業務成果を定期的に測定するための基本的な方法を解説します。特定の研究や製品の評価結果を、そのまま一般的な業務システムやエージェント全体に当てはめるのではなく、自社の業務に合わせて評価設計を行うことが前提です。
前提と準備
継続ベンチマークは、単発の精度測定ではありません。一定の評価軸を維持しながら、業務内容やデータの変化を反映し、定期的に比較する仕組みです。
準備するものは次のとおりです。
- 評価対象となる業務プロセス
- 実際の利用に近い質問、指示、入力データ
- 正解または評価基準
- 評価用の固定データセット
- 新しいデータを追加する仕組み
- モデル、プロンプト、検索設定のバージョン管理
- 品質、処理時間、費用を記録する実行ログ
- 業務担当者によるサンプル確認の時間
- 個人情報や機密情報を扱う場合の社内ルール、匿名化、アクセス権限の確認
評価対象は、可能であればモデル単体ではなく、実際に利用する構成全体として設計します。ただし、どこまでを評価対象に含めるかは業務によって異なります。
検索拡張生成を使う場合は、検索結果、生成回答、引用元、処理時間などを記録すると、問題が検索にあるのか、生成にあるのかを切り分けやすくなります。これらは継続評価で有用な記録項目ですが、特定の研究が一般的な必須項目として定めているわけではありません。
エージェントを評価する場合は、呼び出したツール、実行順序、失敗回数、最終成果物などを評価対象に含める方法があります。こちらも、エージェントの目的やリスクに応じて項目を選びます。
評価指標は、少なくとも次の4群に分けます。
| 評価群 | 指標例 |
|---|---|
| 品質 | 正確性、網羅性、根拠提示、指示遵守、危険な誤回答 |
| 業務成果 | 作業時間、修正回数、完了率、担当者の受容度 |
| 性能 | 応答時間、タイムアウト率、ツール実行成功率 |
| 経済性 | 1件当たり費用、月額費用、費用当たりの完了件数 |
最新動向
電子カルテ検索を対象とした研究では、縦断的な診療記録から質問と回答の組を作成し、臨床医による検証を行う評価方法が検討されています。複数の文書や複数回の受診にまたがる情報を統合する課題を含められる点は、単純な一問一答のテストとは異なる特徴です。
この研究は臨床用LLMの情報検索評価を扱ったものであり、一般的な業務エージェント全般の評価方法や、利用状況・費用を含む継続ベンチマークの有効性を直接証明するものではありません。ただし、実際の業務記録に近いデータを使い、専門家が評価するという考え方は、他業界の評価設計にも応用できます。
出典: Continuous Benchmarking for Clinical LLMs in EHR Information Retrieval
この研究が直接測ったのは電子カルテからの情報検索品質です。以下の費用、速度、業務成果を加える方法は、研究結果そのものではなく、企業が導入判断に使うための実務設計です。
手順
1. 評価する業務を一つに絞る
最初から全社の生成AIを評価しようとすると、正解の定義が曖昧になります。
まずは、次の条件を満たす業務を一つ選びます。
- 入力と出力が明確
- 月に一定数以上の実行がある
- 担当者が品質を判定できる
- 誤りが発生した場合の影響を説明できる
- 現在の作業時間や修正負荷を測定できる
例えば、次のような業務が候補になります。
- 製造業の設備保全記録から過去事例を検索する業務
- エネルギー企業の運転日報を要約する業務
- 化学企業の規程に基づく問い合わせ対応
- 金融機関の社内規程検索
- 大企業の情報システム部門における社内ヘルプデスク対応
最初の1件は、誤回答の影響を管理しやすく、担当者が採点できる業務を選びます。高リスクな判断を完全自動化する業務から始めるのではなく、担当者が最終確認できる補助業務から始めると、評価と改善を進めやすくなります。
2. 実業務に近い評価データを作る
評価データは、単純な質問だけで構成しないでください。実際の業務では、複数の文書、異なる日付、表記ゆれ、欠損情報を扱います。
次の観点を含めます。
- 一つの文書だけで回答できる質問
- 複数文書を突き合わせる質問
- 複数時点の情報を統合する質問
- 条件分岐や計算を含む質問
- 情報が存在しない場合に「不明」と答える質問
- 権限外の情報を要求する質問
- 曖昧な依頼や誤記を含む質問
- 古い規程と新しい規程を区別する質問
- 例外条件や特殊ケースを含む質問
電子カルテ検索の継続評価を扱った研究では、縦断的な記録から質問と回答の組を生成し、臨床医による検証を行っています。静的な問題集だけでなく、複数文書や複数回の受診にまたがる情報統合を評価できる点が参考になります。
自社で作成する場合は、実際の問い合わせや作業記録を匿名化・抽象化し、業務担当者が評価可能な形式に変換します。個人情報や機密情報を含む場合は、利用目的、保管場所、アクセス権限、保存期間を社内ルールに沿って確認します。
3. 正解と採点基準を分けて定義する
正解文を一つだけ用意すると、表現の違いを誤答と判定しやすくなります。そこで、正解そのものと採点基準を分けて定義します。
例えば情報検索なら、次のように評価します。
- 必須情報が含まれているか
- 事実と異なる情報がないか
- 根拠文書を提示しているか
- 質問の範囲を超えて推測していないか
- 回答が業務担当者にとって利用可能か
各項目を0点、1点、2点で採点する例は次のとおりです。
| 項目 | 0点 | 1点 | 2点 |
|---|---|---|---|
| 必須情報 | 重要情報が欠落 | 一部のみ含む | 必要情報を網羅 |
| 正確性 | 重大な誤りがある | 軽微な誤りがある | 事実と一致 |
| 根拠提示 | 根拠がない、または不適切 | 一部の根拠を提示 | 適切な根拠を提示 |
| 指示遵守 | 指示に従っていない | 一部のみ遵守 | 指示どおりに回答 |
| 実務利用性 | そのまま利用できない | 修正が必要 | 軽微な確認で利用可能 |
合計点を品質スコアとして使うこともできますが、安全性に関わる誤回答は平均点とは別に管理します。例えば、次のような事象を「重大エラー」として記録します。
- 存在しない規程や事例を根拠として示す
- 権限のない情報を開示する
- 重要な禁忌条件や例外条件を見落とす
- 誤った計算結果を確定的に提示する
- 不明な情報を推測で補う
重大エラーは、発生件数、発生率、業務への影響度を別々に確認します。
4. 固定セットと更新セットを分ける
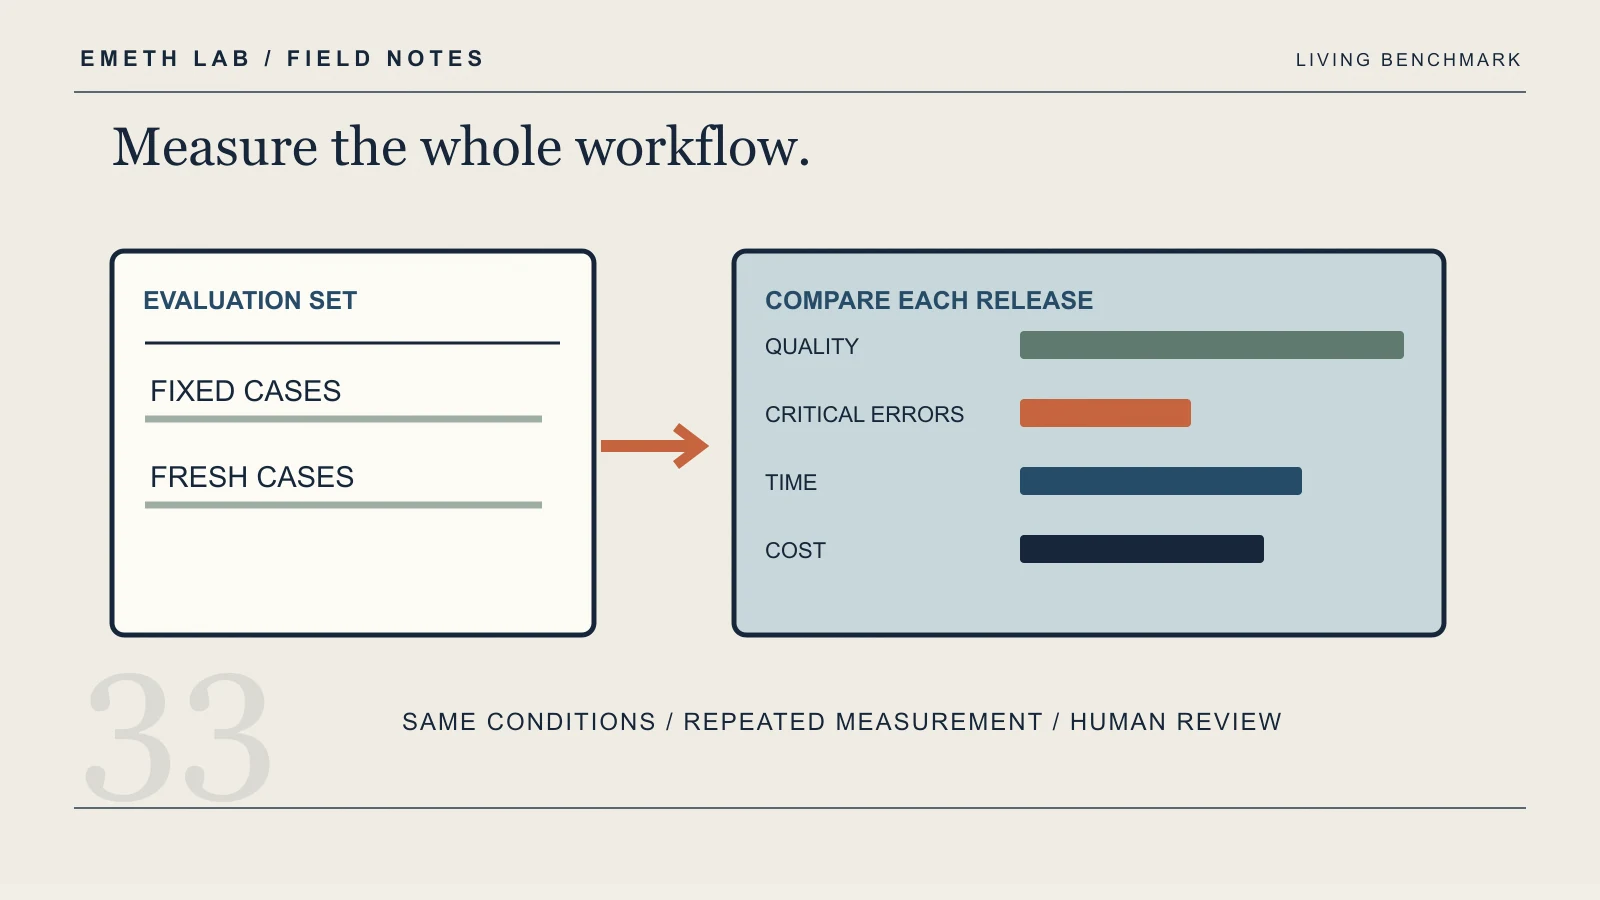
継続評価では、二種類のデータセットを用意します。
固定セットは、モデルや設定を変更しても同じ問題を使い続けます。過去との比較に向いています。
更新セットは、直近の実業務から追加します。新しい製品名、規程、設備、顧客問い合わせなどを反映できます。
固定セットだけでは、評価問題への過適合やデータの陳腐化が起きます。更新セットだけでは、過去の結果との比較が難しくなります。両者を分けることで、安定性と現実適合性を両立できます。
問題数や更新頻度は、業務の変化速度、重大エラーを検出したい確度、担当者が採点できる時間に合わせて決めます。更新問題を固定セットへ移す際は、過去比較に使う固定版を残し、版番号を分けます。
5. 実行条件を記録する
ベンチマーク結果だけでなく、結果が出た条件を保存します。
最低限、次の項目を一つの実行単位に紐づけます。
- 実行日時
- モデル名とバージョン
- システムプロンプトのバージョン
- 検索インデックスのバージョン
- 参照文書のバージョン
- 温度などの生成設定
- 入出力トークン数
- 応答時間
- API費用
- ツール呼び出し履歴
- 採点結果
これらは、原因分析に役立つ実務上の記録項目です。すべてを保存できない場合は、まずモデル、プロンプト、参照データ、実行日時、品質スコア、応答時間、費用から始めます。
モデルの名称が同じでも、提供元の更新によって挙動が変わる場合があります。実行日と設定を残さなければ、性能変化の原因を特定できません。
6. 品質・速度・費用を同じ表で比較する
評価結果は、品質だけで判断しないでください。例えば新モデルが同じ正答率でも、処理時間と費用が大きく下がれば、業務上の価値は変わります。
| 版 | 品質スコア | 重大エラー | 平均応答時間 | 1件当たり費用 | 業務判断 |
|---|---|---|---|---|---|
| 現行版 | 計測値 | 計測値 | 計測値 | 計測値 | 基準 |
| 新版 | 計測値 | 計測値 | 計測値 | 計測値 | 品質基準を満たす場合に比較 |
採用判断には、あらかじめ最低条件を置きます。例えば、次のような条件です。
- 重大エラーを増やさない
- 品質スコアを一定水準以上にする
- 応答時間を業務で許容できる範囲に収める
- 1件当たり費用を一定割合以内に抑える
- 業務担当者の修正負荷を増やさない
品質、速度、費用を同じ条件で継続的に比較できるかどうかは、評価環境の設計に左右されます。入力データ、検索対象、プロンプト、生成設定を揃えられない場合は、結果に条件の違いを明記してください。
7. 定期実行と人手レビューを組み合わせる
ベンチマークは、モデル変更時だけでなく定期的に実行します。日次で全件を人手確認する必要はありませんが、次のような運用が現実的です。
- 毎回: 自動採点、費用、応答時間、エラー率を記録
- 毎週: 新規データを追加し、代表サンプルを人手確認
- モデル変更時: 固定セットと更新セットを全件評価
- 月次: 業務成果、利用率、修正回数、担当者の評価を確認
自動評価のスコアが高くても、評価基準そのものが現場とずれている可能性があります。担当者が確認した結果を採点基準の改善に反映し、定期的に評価者間の判定差も確認します。
8. 閾値と改善ルールを決める
継続ベンチマークを運用するには、結果を見た後の対応も決めておく必要があります。
例えば、次のようなルールを設定します。
- 品質スコアが基準未満になった場合は、原因を検索・プロンプト・モデル・データに分類する
- 重大エラーが1件でも発生した場合は、担当者が内容を確認する
- 応答時間が基準を超えた場合は、検索件数や処理手順を確認する
- 費用が一定割合を超えて増えた場合は、モデルやプロンプトの変更履歴を確認する
- 更新セットで新しい失敗パターンが見つかった場合は、固定セットへの追加を検討する
重要なのは、スコアを記録するだけで終わらせないことです。異常を検知したときに、誰が、いつまでに、どの項目を確認するかまで決めておくと、改善サイクルが止まりにくくなります。
日本企業への示唆
日本企業で最初に取り組む場合は、全社共通のベンチマークを作るより、業務部門ごとに評価しやすい一つの業務を選ぶ方が現実的です。
例えば、次のような進め方があります。いずれも導入事例ではなく、評価対象を選ぶための例です。
- 製造業: 設備保全記録の検索から始める
- エネルギー企業: 運転日報の要約と重要事項の抽出から始める
- 化学メーカー: 社内規程に基づく問い合わせ対応から始める
- 大企業の情報システム部門: 社内ヘルプデスクの定型質問から始める
- 金融機関: 社内規程や商品説明資料の検索支援から始める
最初の1ステップは、過去の問い合わせや作業記録から、評価可能な質問を少数選ぶことです。その際、個人情報や機密情報を社内ルールに従って処理し、業務担当者とともに正解と採点基準を作成します。
導入効果を確認する際は、単なる回答精度だけでなく、次の変化を測定します。
- 1件当たりの作業時間
- 担当者による修正回数
- 問い合わせの完了率
- エスカレーション件数
- 利用者が再質問した割合
- 重大エラーの件数
- 1件当たりの処理費用
特に規程検索、保全記録検索、日報要約のように、担当者が最終確認できる業務は、品質と業務成果を結び付けて測定しやすい領域です。一方、医療、金融、法務、安全管理など影響の大きい領域では、ベンチマークのスコアだけで自動化の可否を判断せず、専門家による確認と承認プロセスを残します。
まとめ
生成AIや業務エージェントの導入効果を測るには、モデルの性能だけでなく、実際の業務でどの程度正確に、速く、安く、修正少なく使えるかを継続的に確認する必要があります。
基本的な進め方は次のとおりです。
- 評価する業務を一つに絞る
- 実業務に近い評価データを作る
- 正解と採点基準を分けて定義する
- 固定セットと更新セットを用意する
- モデルやデータなどの実行条件を記録する
- 品質・速度・費用・業務成果を同じ表で比較する
- 自動評価と人手レビューを組み合わせる
- 閾値と改善ルールを決める
臨床用LLMの研究は、更新可能な評価問題を専門家が検証する設計の参考になります。その結果を自社の業務へそのまま適用できるとは限りません。自社のデータ、利用条件、リスクに合わせたベンチマークを作り、定期的に見直すことが重要です。